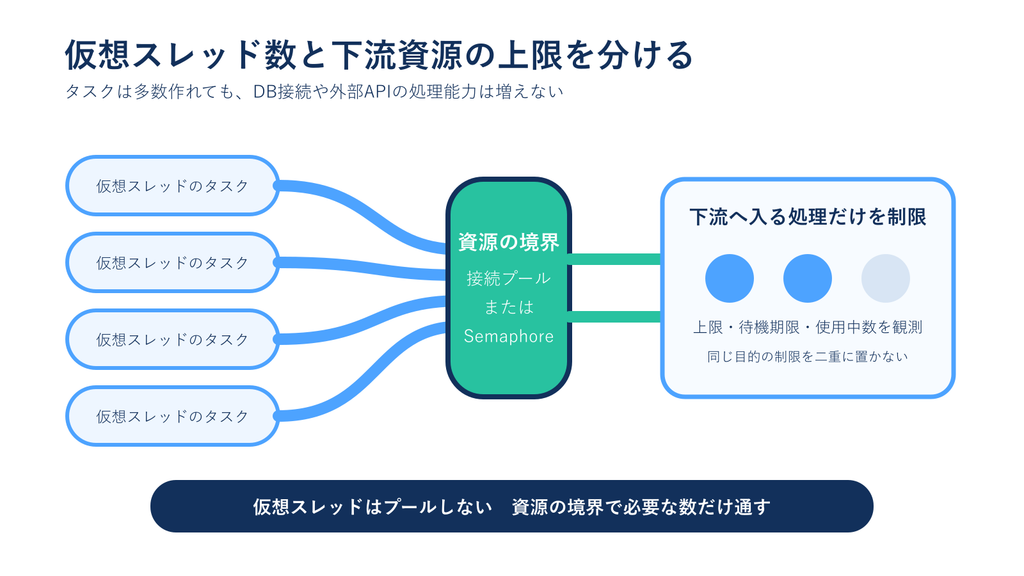
仮想スレッドは、多数の待機中心タスクを扱いやすくする仕組みですが、DB接続数、外部APIの受付能力、メモリ、ファイル記述子を増やすものではありません。タスク数を仮想スレッドの固定プールで抑えるのではなく、制限したい資源の境界に接続プールやSemaphoreを置きます。これにより、タスクは多数存在できても、下流へ同時に入る処理だけを明示した上限に収められます。
掲載コードはJava SE 25のAPIを基準にし、プレビュー機能を使いません。外部API呼び出しは短い待機で模擬します。掲載した上限値はAPIの動作確認用であり、本番環境の推奨値ではありません。
1. 仮想スレッド数と下流資源の数を分ける
1.1 タスクを増やせても接続は増えない
Executors.newVirtualThreadPerTaskExecutor()は、受け付けたタスクごとに新しい仮想スレッドを作ります。固定サイズのスレッドプールのようなタスク実行数の上限は設けません。この性質により、I/O待ちが多い処理を、同期的で読みやすいコードのまま多数扱えます。
しかし、1万個の仮想スレッドを作れても、DB接続プールの最大数が20なら、同時に利用できる接続は20本です。外部APIが同時50要求までを想定しているなら、それを超える要求は遅延や429応答、接続失敗を招く可能性があります。アプリ側のタスク数と、下流が安全に処理できる同時数は別の値です。
| 対象 | 増やす目的 | 主な上限 |
|---|---|---|
| 仮想スレッド | 待機中心タスクを多数表現する | JVMメモリ、保持データ、アプリ全体の負荷 |
| DB接続 | DBとのセッションを使う | DBの接続上限、プール設定、クエリ負荷 |
| 外部API呼び出し | 相手へ要求を送る | 相手の処理能力、レート制限、契約値 |
| ファイル処理 | ファイルを開いて読み書きする | ファイル記述子、ストレージI/O、メモリ |
「仮想スレッドが軽いから上限は不要」と考えると、最も弱い下流へ負荷が集中します。どの資源を守るための制限かを明示することが出発点です。
ここでいう同時実行数は、1秒あたりの要求数とは別です。同時実行10件でも、一件が10ミリ秒で終われば1秒あたり多くの要求を送れます。反対に一件が5秒かかれば、同時実行10件でも処理量は小さくなります。相手が「毎秒100件」と「同時20接続」の両方を定めている場合、Semaphoreだけでは毎秒の上限を表せません。レート制限と同時実行制限を分けて扱います。
負荷の入口にも目を向けます。アプリが受け付ける要求数に上限がなく、下流だけをSemaphoreで守ると、待機する仮想スレッドと要求データが増え続ける可能性があります。下流保護、受付制御、利用者への混雑応答は別の役割です。どれか一つだけで過負荷対策全体が完了すると考えないでください。
1.2 仮想スレッド自体を固定プール化しない
OracleのJDK 25ガイドは、仮想スレッドをプールしないよう説明しています。プラットフォームスレッドの固定プールは、高価なスレッドを再利用しつつ同時実行数を制限する役割を持っていました。仮想スレッドはタスクごとに作ることを想定しているため、再利用のための固定プールは不要です。
下流への同時アクセスを10件にしたい場合、「仮想スレッド10本の固定プール」を作ると、DB以外の待機や前処理まで同じ上限に閉じ込めます。何を守る制限なのかがコードから分かりにくくなり、別の下流に異なる上限を設定することも難しくなります。
代わりに、タスクは仮想スレッドで実行し、制限対象へ入る直前にpermitや接続を取得します。DBには接続プール、接続プール以外の外部サービスにはSemaphoreなど、資源に合った制御を置きます。
仮想スレッド用Executorを固定サイズ化すると、全タスクが同じ枠を奪い合います。API Aは同時5件、API Bは同時50件まで安全でも、一つの10スレッドプールに入れれば、それぞれの能力を表現できません。資源ごとにSemaphoreを分ければ、Aの遅延中でもBのタスクが独立して進められます。
ただし、一つのタスクが複数資源を同時に取得する場合は、取得順の不一致によるデッドロックに注意します。たとえば一方がDB接続を借りてからAPI permitを待ち、別の処理がAPI permitを持ってDB接続を待つ構成です。複数資源を保持する時間を短くし、取得順を統一し、待機期限を設けます。
2. DB接続プールの役割を理解する
2.1 接続取得待ちが同時利用数を制限する
DB接続プールは、一定数の接続を管理し、空きがなければ取得側を待たせる仕組みです。仮想スレッドが1000個あっても、プールの最大接続数が20なら、同時に接続を借りられるタスクは原則20個までです。この意味で、接続プール自体がDB接続という資源に対するSemaphoreのように働きます。
重要なのは、接続を待つタスクが増えたときの挙動です。仮想スレッドは待機を効率よく扱えますが、要求の期限を超えて接続を待ち続けてよいわけではありません。接続取得タイムアウトを設定し、取得できなかった場合をDBの業務エラーと区別します。
接続は、必要な処理の直前に取得し、できるだけ短い範囲で返却します。仮想スレッドごとに接続をThreadLocalへ保存し、複数処理で使い回す設計は避けます。仮想スレッドは非常に多く作られる可能性があるため、各スレッドへ高価な資源や大きなキャッシュを保持すると、軽量性を損ないます。
トランザクション中は、SQLを実行していない時間も接続を保持します。トランザクションを開始したまま外部APIの応答を待つと、接続プールが早く枯渇し、ロック保持時間も延びます。外部呼び出しとDB更新の順序を見直し、トランザクション範囲に不要な待機を含めないようにします。
接続プールの最大値をDBの最大接続数と同じにすることも避けます。複数アプリのインスタンス、管理接続、監視、バッチが同じDBを使うなら、全インスタンスの合計と余裕が必要です。アプリ1台の設定だけを見て安全と判断せず、スケールアウト後の総接続数を計算します。
2.2 同じ上限を二重に設けない
DB接続プールが最大20接続に制限しているのに、その直前へ20 permitのSemaphoreを追加しても、同じ資源を二重に制限するだけになりやすいです。待機場所が二つに分かれ、どちらで詰まっているか分かりにくくなります。Oracleのガイドでも、接続プールがすでに同時数を制限するため、その目的だけの追加Semaphoreは不要と説明されています。
ただし、異なる目的の上限なら別です。たとえばDB接続プールは20本だが、特定の重い集計クエリは同時3件までにしたい場合、その業務処理専用のSemaphoreを置く判断があります。全接続数と、重い処理の同時数は守る対象が異なります。
制限を追加する前に、次の問いへ答えます。
- 何という資源や相手を守る上限か
- 既存のプールやクライアントが同じ制限をすでに持っていないか
- 上限に達したタスクは、どこで何秒待つか
- 待機数と時間切れ数をどの指標で確認するか
答えが「何となく処理数を減らすため」なら、上限の場所と値を再検討します。
二重制限が必ず誤りというわけではありません。接続プール20本のうち、オンライン要求へ15本程度を残し、重いバッチだけを同時3件にするような別目的の上限は意味があります。この場合は、Semaphoreの名前をHEAVY_REPORT_SLOTSのように目的が分かるものにし、接続数とは異なる判断基準を文書化します。
また、アプリの複数インスタンスに置いたSemaphoreは、それぞれのJVM内だけで有効です。3台のインスタンスが各10 permitなら、全体では最大30件が下流へ向かいます。相手側の上限が全体で10件なら、各インスタンスへの配分、中央のレート制御、または相手側の制限を考慮する必要があります。
3. Semaphoreで外部APIの同時実行数を制限する
3.1 permitを資源の利用権として扱う
Semaphoreは、指定数のpermitを管理します。タスクはacquire()でpermitを取得し、処理後にrelease()で返します。permitがなければacquire()は待機し、割り込まれればInterruptedExceptionを送出します。
次のLimitedCalls.javaは、20個のタスクを仮想スレッドへ投入し、外部APIに相当する部分だけを同時3件へ制限します。仮想スレッドの数を3本に制限しているわけではありません。
import java.time.Duration;
import java.util.ArrayList;
import java.util.List;
import java.util.concurrent.ExecutorService;
import java.util.concurrent.Executors;
import java.util.concurrent.Future;
import java.util.concurrent.Semaphore;
import java.util.concurrent.atomic.AtomicInteger;

public class LimitedCalls {
    private static final Semaphore API_SLOTS = new Semaphore(3);
    private static final AtomicInteger ACTIVE = new AtomicInteger();
    private static final AtomicInteger MAX_ACTIVE = new AtomicInteger();

    public static void main(String[] args) throws Exception {
        try (ExecutorService executor =
                Executors.newVirtualThreadPerTaskExecutor()) {
            List<Future<String>> futures = new ArrayList<>();
            for (int id = 1; id <= 20; id++) {
                int requestId = id;
                futures.add(executor.submit(() -> callApi(requestId)));
            }
            for (Future<String> future : futures) {
                System.out.println(future.get());
            }
        }
        System.out.println("max active=" + MAX_ACTIVE.get());
    }

    private static String callApi(int requestId) throws InterruptedException {
        API_SLOTS.acquire();
        try {
            int current = ACTIVE.incrementAndGet();
            MAX_ACTIVE.accumulateAndGet(current, Math::max);
            Thread.sleep(Duration.ofMillis(100));
            return "request-" + requestId;
        } finally {
            ACTIVE.decrementAndGet();
            API_SLOTS.release();
        }
    }
}実行すると20件すべてが処理されますが、模擬API部分のmax activeは3になります。AtomicIntegerは説明用の観測値であり、Semaphoreの制御そのものには使っていません。
この例では、Semaphoreをstatic finalとしてアプリ内で共有しています。要求ごとにnew Semaphore(3)を作ると、各要求が3 permitを持つため、アプリ全体の上限になりません。どの範囲で共有すべきかは制限対象と一致させます。一つのJVM内の外部API利用を制限するなら、そのAPIクライアントと同程度の寿命で共有します。
一方、顧客ごとに別の契約上限があるなら、顧客単位の制御が必要です。キーごとのSemaphoreを無制限にMapへ追加すると別のメモリ問題が生じるため、キー数、失効、削除を設計します。本記事の単一Semaphoreは、全要求で一つの上限を共有する基本形です。
3.2 finallyでpermitを必ず返す
permit取得後に例外や割り込みが発生しても、release()を実行する必要があります。返却を通常経路の末尾だけに書くと、一度の失敗でpermitが失われ、やがて全タスクが待ち続けます。取得後の処理をtryで囲み、finallyで返します。
一方、permitを取得できていないのにrelease()してはいけません。acquire()がInterruptedExceptionで失敗した場合は、上のコードではtryへ入らないため返却しません。時間付きtryAcquireを使う場合も、戻り値がtrueのときだけfinallyで返す構成にします。
permitを保持する範囲は、守りたい資源を実際に使っている部分だけにします。入力検証やレスポンス変換まで囲むと、外部APIを使っていない時間にも枠を占有し、実効的な処理能力を下げます。反対に、要求を送信した後だけ取得しても、負荷を制限できません。
複数回の外部呼び出しを一つのpermitで囲むか、呼び出しごとに取得するかも検討します。一連の処理をまとめて囲むと要求間の整合を保ちやすい場合がありますが、通信していない時間もpermitを保持します。呼び出しごとに返せば利用効率は上がりますが、途中で別タスクが入り、二回目の取得に時間がかかる可能性があります。守る対象と業務の一貫性から範囲を決めます。
release()を二回呼ぶとpermit数が初期値を超え、制限が壊れます。Semaphoreは所有者を記録しないため、別スレッドからのreleaseも可能です。便利な性質ですが、取得成否をbooleanで保持し、一回だけ返却する構造を徹底します。独自ラッパーを作る場合は、try-with-resourcesのように返却位置を固定する方法もあります。
4. 待機時間と公平性を設計する
4.1 tryAcquireで待機にも期限を設ける
acquire()はpermitが得られるまで待ちます。要求全体に期限があるサービスでは、Semaphoreの待機にも期限を設けます。時間付きtryAcquireは、指定時間内にpermitを取得できたかをbooleanで返します。
static String callApiWithTimeout(int requestId) throws InterruptedException {
    boolean acquired = API_SLOTS.tryAcquire(300, java.util.concurrent.TimeUnit.MILLISECONDS);
    if (!acquired) {
        throw new IllegalStateException("API slot timeout: " + requestId);
    }
    try {
        Thread.sleep(100);
        return "request-" + requestId;
    } finally {
        API_SLOTS.release();
    }
}
この300ミリ秒は外部APIの応答期限ではなく、呼び出しを開始する枠を待つ期限です。permit取得後には、HTTPクライアント側の接続・応答タイムアウトが別に必要です。待機と通信を足した時間が要求全体の期限を超えないようにします。
枠を取得できなかった場合の応答も決めます。無条件に同じExecutorへ再投入すると、待機タスクがさらに増える可能性があります。利用者へ混雑を通知する、キューへ移す、処理を縮退するなど、業務要件に合う方針を選びます。
待機期限は、要求全体の残り時間より短くします。すでに期限まで100ミリ秒しかないのに300ミリ秒待つ設定では、上位が先に諦めた後も処理が残ります。前記事と同様に、処理開始時の締切から残り時間を計算し、permit待ちと実際のI/Oへ配分します。
Semaphore待機中の仮想スレッドは、プラットフォームスレッドを占有し続けない形で待機できます。しかし、待機タスクの入力データやFutureは保持されます。待機が安価であることと、無限に待機させてよいことを混同しないようにします。
4.2 fairモードとスループットの違い
new Semaphore(3, true)のように公平性を有効にすると、待機中のスレッドへおおむね先着順でpermitを与えます。長く待つタスクが取り残される可能性を下げられますが、公平性の管理によりスループットが低下する場合があります。
デフォルトの非公平モードでは、permitが返った時点で新しいタスクが先に取得する可能性があります。短い処理を大量に扱い、最大スループットを重視する場合に適することがあります。一方、同じ利用者や業務が長時間待たされることを避けたい場合は、公平性を含めて負荷試験します。
なお、引数なしのtryAcquire()は公平モードでも待機順を尊重せず、利用可能なpermitを取得できます。公平性を有効にしただけで、すべての取得方法が完全なFIFOになると説明しないでください。実際の要求順、待機時間、タイムアウト率を観測して判断します。
公平性は業務の優先順位も表しません。障害対応の処理、利用者向けオンライン処理、夜間バッチを同じSemaphoreへ入れれば、先着順でも重要な要求が待つ可能性があります。優先度が必要なら、単純な公平Semaphoreだけに任せず、処理経路やキューを分ける設計を検討します。
逆に、多数の優先度と専用Semaphoreを作ると、合計が下流上限を超える可能性があります。全体上限と種別上限を組み合わせる場合は、取得順を統一し、最大値の合計を確認します。制御が複雑になるほど、負荷試験と観測項目を増やす必要があります。
5. 上限値を計測から決める
5.1 下流の能力と契約を出発点にする
Semaphoreのpermit数をCPUコア数から機械的に決めることはできません。外部APIなら、相手が許容する同時要求、レート制限、通常とピークの応答時間、接続上限が出発点です。DBなら、接続プールの最大値、DB全体の接続上限、クエリの種類、トランザクション時間を確認します。
Littleの法則を簡単な見積もりに使うことはできます。1秒あたり50件を処理し、外部APIの平均応答が0.2秒なら、平均的には約10件が同時に処理中になります。ただし、平均だけでは遅い要求や突発負荷を表せません。p95・p99、タイムアウト率、相手側の安全余裕を含めて検証します。
値を上げると、一時的にアプリの待機は減っても、下流の応答が悪化して全体の処理能力が下がることがあります。逆に低すぎると、下流に余裕があるのにアプリ側で待たせます。permit数を一度決めて終わりにせず、負荷条件と結果を記録して変更します。
検証では、permit数を数段階変え、スループット、p95・p99遅延、時間切れ、CPU、メモリ、下流エラーを同じ条件で比較します。最大スループットの一点だけを採用せず、ピーク時にも下流が回復できる余裕を残します。相手サービスが共有基盤なら、ほかの利用者への影響も考慮します。
本番値を設定ファイルへ出す場合は、変更履歴と根拠を残します。値を動的に変えられるようにしても、減少時に使用中permitをどう扱うか、インスタンスごとの値が揃うかを確認します。容易に変更できることと、安全に変更できることは別です。
5.2 タスク数と保持データにも上限を設ける
下流の同時実行数をSemaphoreで抑えても、何百万件ものタスクを一度に作れば、Future、入力データ、ラムダがメモリに残ります。仮想スレッド自体が軽量でも、アプリがタスクごとに保持するデータは消えません。
大量バッチでは、入力を一定件数ずつ読み、完了した結果を回収してから次を投入する方法を検討します。これは仮想スレッドを固定プールへ戻す話ではなく、アプリが未完了仕事をどれだけ保持するかという受付制御です。Web APIでは、サーバやロードバランサの同時要求数、キュー長、利用者ごとの制限も関係します。
ThreadLocalにも注意が必要です。従来の小さな固定プールでは、スレッドごとのキャッシュが限られた数で済みました。タスクごとに仮想スレッドを作る構成で大きなオブジェクトや接続をThreadLocalへ保存すると、タスク数に応じて保持量が増えます。要求IDのような小さな情報でも寿命を明確にし、高価な資源の再利用手段として使わないでください。
投入側がデータベースから全件を読み込んでからタスク化すると、Semaphoreが下流を守っても入力側のメモリ使用量は増えます。ページングやストリーム処理で一定件数ずつ読み、完了分を破棄できる構成にします。未完了件数をメトリクス化し、設定した高水位を超えたら新規投入を一時停止する方法もあります。
受付制御でタスクを拒否する場合は、処理を失ったことが分かる応答や記録が必要です。単にログへ出して捨てると、利用者は受け付けられたと思う可能性があります。同期APIなら混雑応答、非同期ジョブなら永続キューなど、要求の契約に合わせます。
6. 待機・使用中・失敗を観測する
6.1 制限が効いていることの確認
本番前の試験では、最大使用数が上限を超えないことだけでなく、待機した件数と時間も測ります。上限3で最大使用数が3なら制御は動いていますが、毎回数秒待つなら、受付量、期限、下流能力のどこかが合っていません。
接続プールでは、使用中接続数、アイドル接続数、接続取得待ち数、取得タイムアウト数を確認します。Semaphoreでは標準APIだけで完全な運用指標が揃うわけではないため、処理開始前後の時刻、permit取得成功・時間切れ、処理中件数をアプリ側で計測します。
| 指標 | 分かること | 注意点 |
|---|---|---|
| 使用中数 | 下流へ同時に入っている処理数 | 上限に張り付く時間を見る |
| 待機数 | permitや接続を待つタスク数 | 瞬間値だけでなく増加傾向を見る |
| 待機時間 | 下流へ入る前の遅延 | API応答時間と分けて計測する |
| 時間切れ数 | 枠や接続を得られなかった件数 | 下流の失敗と混同しない |
| 処理時間 | 資源を保持した時間 | 長い処理が枠を占有していないか調べる |
| 入力件数 | 作成・待機している仕事の量 | 使用中数だけでは滞留量が分からない |
要求IDや対象IDを使い、待機開始、取得、下流呼び出し、返却、時間切れを追跡できるようにします。ただし高頻度処理で全件の詳細ログを出すと、ログ自体が負荷になるため、メトリクスやサンプリングとの役割分担も考えます。
ダッシュボードでは、アプリの受信件数、Semaphore待機、接続プール待機、下流応答時間を同じ時間軸へ並べます。下流応答が先に悪化して待機が増えたのか、入力急増が先だったのかを確認できます。平均値だけでは短い枯渇を隠すため、最大値や高いパーセンタイルも使います。
アラートは「使用中数が上限に達した」だけで出すと、正常に能力を使い切っている時間にも通知されます。待機時間の増加、時間切れ率、エラー率、一定時間の継続を組み合わせ、利用者影響がある状態を検知します。
6.2 permit漏れと二重制限の切り分け
時間とともに同時実行数が減り、最後はすべて待つ場合は、例外経路でpermitを返していない可能性があります。finallyがすべての取得成功経路を囲んでいるか、取得前にrelease()していないかを確認します。割り込み試験を行い、処理途中でもpermit数が元に戻ることを検証します。
待機時間が想定より長い場合は、Semaphoreだけを疑わず、接続プールやHTTPクライアント内部にも別の上限がないか確認します。Semaphoreで10件を許可していても、接続プールが5なら、残り5件は別の場所で待ちます。複数の制限を図にし、それぞれの上限、待機期限、指標を並べると調査しやすくなります。
障害試験では、下流応答を意図的に遅くし、使用中数が上限で止まること、待機側が設定時間で戻ること、回復後にpermit数が戻ることを確認します。途中でタスクをcancel(true)し、割り込み経路でもreleaseされるかを調べます。正常試験だけでは、最も起きやすいpermit漏れを発見できません。
アプリ停止時も確認が必要です。新規受付を止め、待機中タスクへ停止を伝え、使用中処理の終了を期限付きで待ちます。共有Semaphoreそのものを閉じるAPIはないため、Executorと要求受付のライフサイクルで制御します。停止途中に新しいタスクがpermit待ちへ入らない順序にします。
本番投入前には、次の項目を確認します。
| 確認項目 | 合格条件 |
|---|---|
| 制限対象 | DB、外部APIなど守る資源を名前で説明できる |
| 実装位置 | 資源を使う直前で取得し、使用直後に返却する |
| 二重制限 | 同じ目的の接続プールとSemaphoreを重ねていない |
| 例外経路 | 失敗・割り込みでもpermitや接続を返却できる |
| 待機期限 | 接続取得・permit待ち・I/Oの期限が分かれている |
| 保持量 | 未完了タスクと入力データが無制限に増えない |
| ThreadLocal | 接続や大きなキャッシュを仮想スレッドごとに持たない |
| 観測 | 使用中数、待機時間、時間切れ、下流応答を区別できる |
仮想スレッドを導入した直後は、スレッド不足が見えにくくなる一方、下流の上限が新しいボトルネックとして明確になります。これは仮想スレッドの失敗ではなく、もともと存在した資源制限を適切な境界で扱う必要があるということです。
まとめ
仮想スレッドはタスクごとに作り、再利用のための固定プールへ入れません。DB接続数や外部APIの同時要求数は別の資源制限です。DB接続は既存の接続プールに任せ、同じ上限のSemaphoreを重ねないようにします。外部APIなど専用の制限がない資源には、境界の直前でSemaphoreを取得し、finallyで確実に返します。
上限値は、下流の処理能力、契約、遅延分布、アプリが保持する未完了タスク量から決めます。使用中数だけでなく、permit・接続の待機時間、時間切れ、下流の応答を分けて観測してください。タスク数と資源数を分離して設計することで、仮想スレッドの扱いやすさを保ちながら、DBや外部サービスへの過負荷を防げます。