Traceは、あるリクエストや処理がシステム内を通った一連の経路を表し、Spanはその経路を構成する個別の処理単位を表します。OpenTelemetryでは、複数のSpanをTrace IDと親子関係で結び、HTTPヘッダーなどを通じて識別情報を次のサービスへ引き継ぐことで、プロセスやネットワークの境界を越えた処理を一つの流れとして追跡します。
1. TraceとSpanの違い
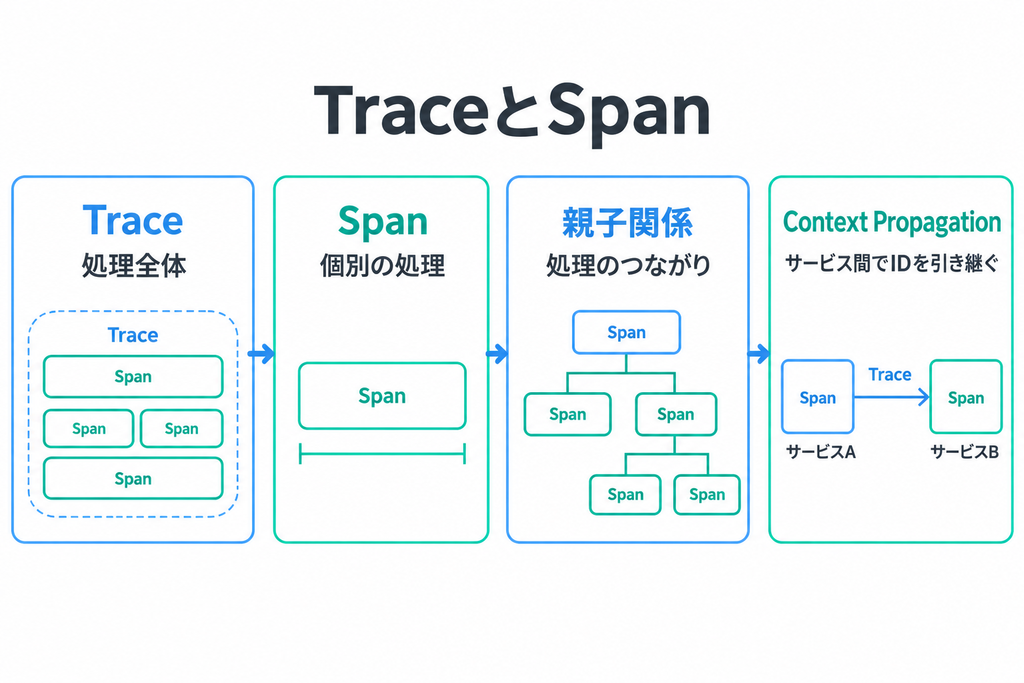
Traceは一つの処理全体を表す
Traceは、利用者の一つの操作や、一つの業務処理によって発生した処理の流れ全体を表します。たとえば注文ボタンを押してから、注文API、在庫確認、決済、結果返却まで進む一連の流れが一つのTraceです。
分散システムでは、一つのリクエストが複数のサービスやプロセスを通過します。サーバーごとのログだけを見ると別々の処理に見えますが、同じTrace IDを持つデータを集めれば、一つの要求から発生した処理としてまとめられます。
Traceは特定の一行ログではありません。複数のSpanと、それらの因果関係から組み立てられる構造です。開始から終了までの全体像を表す概念として理解すると混乱しにくくなります。
Spanは一つの処理区間を表す
Spanは、Traceの中にある個別の処理単位です。HTTPリクエストの受信、別サービスへのHTTP送信、SQL実行、メッセージ処理などがSpanの例です。
各Spanは、処理名、開始時刻、終了時刻、属性、イベント、状態などを持ちます。これにより「どの処理に何ミリ秒かかったか」「どのHTTPルートでエラーになったか」を調べられます。
Spanの粒度は細かければよいわけではありません。すべてのメソッドをSpanにするとデータ量が増え、重要な境界が見えにくくなります。外部通信、DBアクセス、業務上重要な処理など、調査時に区別したい単位で作成します。
親子関係で処理の因果関係を表す
Spanには親子関係を持たせられます。リクエストを最初に受け付けたSpanを起点とし、その処理から呼び出されたDBアクセスや外部API呼び出しを子Spanとして関連付けます。
たとえば注文APIのSpanから、在庫確認Spanと決済Spanが作られた場合、どちらも注文APIを親に持ちます。開始・終了時刻と親子関係を並べることで、直列処理か並列処理か、待ち時間がどこにあるかを視覚化できます。
親は通常一つですが、バッチ処理や複数メッセージをまとめる処理では、複数の処理との因果関係を表したい場合があります。その場合はSpan Linkを使うことがあります。単純な同期HTTP処理では、まず親子関係を正しく作ることが基本です。
2. Spanに記録される情報
名前と開始・終了時刻
Span名は、その区間で何をしているかを表します。GET /orders/{id}、SELECT orders、payment.authorizeのように、処理内容を判別できる名前を付けます。
開始時刻と終了時刻から、そのSpanの所要時間を計算できます。親Spanが500ミリ秒、その子である外部API Spanが450ミリ秒なら、遅延の大部分が外部API呼び出しにあると推測できます。
URLへ実際の注文IDを含めるなど、値ごとにSpan名を変える設計は避けます。名前の種類が増えすぎて集計しにくくなるため、ルートテンプレートや定義済みの処理名を使用します。
Attributesで処理の条件を補足する
Attributesは、Spanに付けるキーと値の情報です。HTTPメソッド、HTTPルート、サーバーアドレス、DB種別など、処理を絞り込むための条件を記録します。
OpenTelemetryにはSemantic Conventionsがあり、一般的なHTTP、DB、メッセージングなどの属性名を共通化しています。独自の名前を大量に作る前に、対象分野の規約を確認すると、サービス間で検索条件をそろえやすくなります。
属性へ個人情報や認証トークンを記録してはいけません。また、取引IDのように値の種類が非常に多い属性は、バックエンドの保存量や検索性能へ影響する場合があります。調査価値とコストの両方で判断します。
EventsとStatusで途中経過や結果を表す
Span Eventは、Spanの実行中に起きた特定の出来事を、時刻と属性付きで記録する仕組みです。例外の発生やリトライなど、Spanを分割するほどではない出来事を残す用途があります。
Statusは、そのSpanの結果を表します。OpenTelemetryではUnset、Ok、Errorという状態があり、エラー判定や可視化に利用されます。ただし、HTTP 404を常にシステム障害とみなすかは、処理の役割によって異なります。
例外を記録しただけで自動的にStatusがErrorになるとは限らないため、利用するSDKや自動計装の挙動を確認します。業務エラーとシステムエラーを同じ基準で扱わないことも重要です。
3. Trace IDとSpan IDの役割
Trace IDは処理全体をまとめる識別子
Trace IDは、一つのTraceに含まれるすべてのSpanを関連付ける識別子です。サービスA、サービスB、DBアクセスの各Spanが同じTrace IDを持つことで、一連の処理として検索できます。
OpenTelemetry仕様では、Trace IDは16バイトの識別子として扱われます。十分に重複しにくい値を生成し、サービス間で引き継ぎます。
Trace IDは利用者向けの受付番号と同じものではありません。問い合わせ番号や取引IDを別の属性として関連付ける場合でも、外部へ不用意に公開するか、どの期間保存するかを検討します。
Span IDは個別処理を識別する
Span IDは、Trace内の個々のSpanを識別します。OpenTelemetry仕様では8バイトで、子Spanへ渡されたときには親を示す識別子として使われます。
同じTrace IDを持つSpanの中で、どのSpanから次のSpanが作られたかをSpan IDと親Span IDで表現します。これにより、単なる時刻順ではなく因果関係を組み立てられます。
Trace IDだけをログへ出しても処理全体の絞り込みはできますが、Span IDもあれば、そのログがどの区間で出力されたかまで特定しやすくなります。
SpanContextは追跡に必要な情報をまとめる
SpanContextは、Spanを参照し、別の処理へ追跡情報を伝えるためのデータです。Trace ID、Span ID、Trace Flags、TraceStateなどを含みます。
Trace Flagsには、代表的なものとして、そのTraceを記録対象にするかを表すサンプリング情報があります。TraceStateは、複数のトレーシングシステムが追加情報を引き継ぐために利用できます。
アプリケーションでSpanContextを独自文字列として組み立てるのではなく、OpenTelemetry SDKと標準のPropagatorを利用します。形式の誤りや引き継ぎ漏れを防ぐためです。
4. Context Propagationの仕組み
サービス境界を越えてContextを渡す
Context Propagationは、現在処理しているTraceやSpanの情報を、次のサービスや非同期処理へ引き継ぐ仕組みです。これがなければ、各サービスで別々のTraceが開始され、一つの経路としてつながりません。
送信側は現在のContextをHTTPヘッダーなどへ注入し、受信側はその値を抽出して親Contextとして利用します。受信側が新しいSpanを作ると、送信側のSpanとの親子関係が成立します。
OpenTelemetryの自動計装が対応しているHTTPクライアントやサーバーでは、この注入と抽出が自動化されることがあります。ただし、独自通信、未対応ライブラリ、途中のプロキシなどでは引き継ぎ状況を確認する必要があります。
W3C Trace ContextでHTTPヘッダーへ載せる
OpenTelemetryでは、分散トレースの伝播形式としてW3C Trace Contextを一般的に利用します。主なHTTPヘッダーはtraceparentとtracestateです。
traceparentには、バージョン、Trace ID、親となるSpan ID、フラグが含まれます。受信側はこの情報を読み取り、自分が作るSpanを同じTraceへ所属させます。
ヘッダーをログへそのまま大量出力したり、アプリケーションが形式を独自に書き換えたりしないよう注意します。信頼できない外部から受け取ったTrace Contextの扱いも、サービス境界とセキュリティ方針に合わせて決めます。
Contextが切れる代表的な場面
Contextは、非同期処理、独自スレッド、メッセージキュー、対応していないHTTPクライアントなどで切れることがあります。結果として、一つの処理が複数のTraceに分断されます。
たとえばHTTPリクエストを受けた後に独自Executorへ処理を渡す場合、現在のContextを新しい実行単位へ正しく関連付ける必要があります。利用する言語やフレームワークによって方法が異なるため、SDKの公式手順を確認します。
トレースが途中で分かれた場合は、受信側だけでなく送信側も確認します。送信ヘッダーへの注入、通信経路でのヘッダー保持、受信側での抽出、Span作成時の親Context指定を順に切り分けます。
5. 具体例で処理の流れを追う
注文APIを構成するSpan
注文処理を例にすると、ブラウザから注文APIへのリクエストを受けたSpanが起点になります。その子として在庫サービスへのHTTP呼び出し、DBへの注文登録、決済サービスへのHTTP呼び出しが作られます。
POST /orders
├─ GET inventory-service/items/{id}
├─ INSERT orders
└─ POST payment-service/payments
   └─ INSERT payments
この図は、Trace内の親子関係を簡略化したものです。実際の表示では各Spanの開始時刻と所要時間も並ぶため、処理が直列か並列か、どこで待っているかを確認できます。
遅延箇所を特定する
注文API全体に1.2秒かかり、そのうち決済サービスへの呼び出しが900ミリ秒なら、最初に決済経路を調べる判断ができます。さらに決済サービス内のDB Spanが850ミリ秒なら、調査対象をDB処理まで絞れます。
Traceがない場合、各サービスの時刻とリクエストIDを手作業で照合する必要があります。TraceとSpanがつながっていれば、一つの経路から関連する区間へ移動できます。
ただし、Spanの時間だけで原因を断定してはいけません。キュー待ち、接続プール不足、ネットワーク、サンプリング、計測方法なども影響します。Traceは原因を確定する答えではなく、調査範囲を狭める材料です。
エラーの伝播を確認する
決済サービスがHTTP 503を返した場合、呼び出し側Spanにレスポンス状態を記録し、必要に応じてStatusをErrorにします。注文APIがそのエラーをどのように処理したかも別のSpanで確認できます。
リトライがある場合、複数回の外部呼び出しをそれぞれSpanとして記録すると、何回目で成功したか、合計時間がどれだけ増えたかを把握できます。
業務上想定された拒否と、システム障害は区別が必要です。残高不足のような業務結果をすべて障害扱いにすると、本当に対応すべきエラーが埋もれます。
6. Span設計で注意すること
業務上の境界を意識する
自動計装ではHTTPやDBなど技術的な境界を取得できますが、「与信確認」「振込予約」といった業務上の処理までは自動で判断できません。調査価値が高い処理には手動Spanを追加する選択肢があります。
一方、すべてのメソッドにSpanを作ると、Traceが巨大になり、保存量も増えます。外部依存、時間がかかる処理、失敗時に切り分けたい処理を優先します。
Spanを追加する前に、その情報でどの判断ができるかを確認します。既存の親Spanと同じ情報しか持たないSpanは、増やさない方が見やすい場合があります。
属性名を統一する
同じ意味の属性をサービスごとに別名で記録すると、横断検索が難しくなります。OpenTelemetry Semantic Conventionsに定義がある項目は、それに従うことを基本とします。
独自属性が必要な場合は、命名規則、値の型、機密区分、保持方針をチームで決めます。自由入力の文字列より、列挙された状態や種別の方が集計しやすくなります。
Semantic Conventionsは更新されるため、利用しているSDKと規約の安定性を確認します。記事や設定例をそのままコピーせず、対象バージョンの公式情報を参照します。
個人情報と高カーディナリティを避ける
Span属性やEventへ、氏名、メールアドレス、認証トークン、カード番号などを記録してはいけません。URLやSQL文に値が埋め込まれる場合も注意が必要です。
また、ユーザーID、注文ID、Trace IDのように値の種類が非常に多い項目は、高カーディナリティな情報です。調査には便利でも、バックエンドのインデックス量や料金を増やす可能性があります。
必要な識別情報は、アクセス権、保持期間、検索頻度を踏まえて扱います。調査用途で個別IDが必要な場合も、機密性の低い代理IDや制限されたログとの関連付けを検討します。
まとめ
Traceは一つのリクエストや処理全体を表し、Spanはその中の個別処理を表します。Trace IDで一連のSpanをまとめ、Span IDと親子関係によって処理の因果関係を組み立てます。
サービス境界を越えて追跡するには、Context Propagationが必要です。送信側がTrace Contextを通信へ注入し、受信側が抽出して親Contextとして利用することで、別プロセスのSpanを同じTraceへ接続できます。Spanの粒度、属性の統一、機密情報、高カーディナリティに注意し、障害調査で判断に使える境界を記録することが重要です。