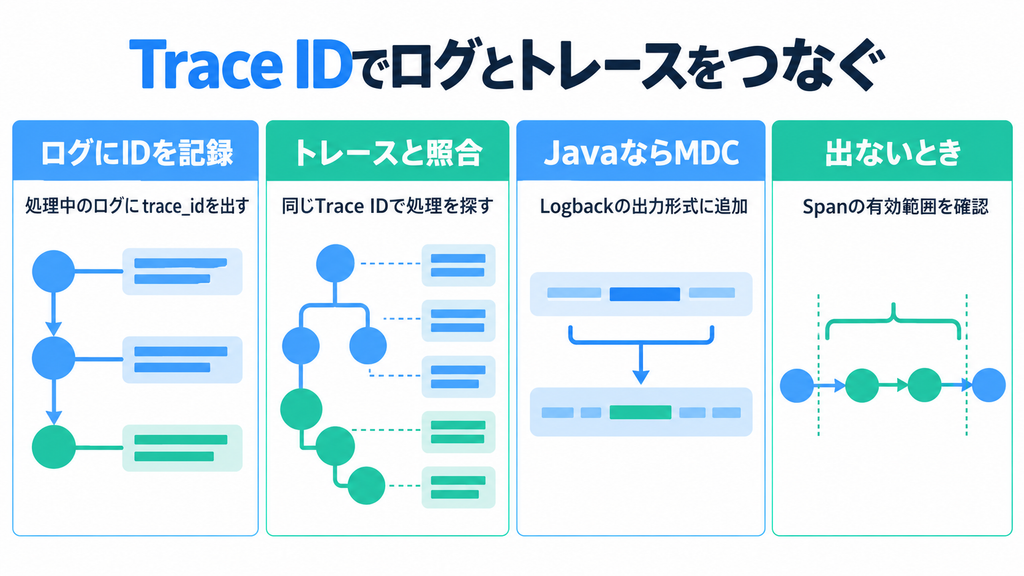
Trace IDは、一つの処理の流れを複数のSpanにまたがって識別する値です。同じTrace IDをアプリケーションログにも記録すれば、エラーのログ行を起点に関連するトレースを探し、どのサービスや外部呼び出しに時間がかかったかを確認できます。Javaでは対応するロギングライブラリとOpenTelemetry Java AgentのMDC連携を使えますが、Agentを起動しただけで既存ログの表示形式まで変わるわけではありません。Spanが有効な場面でIDを出力し、ログ収集側が検索できることまで確かめます。
1. ログとトレースをなぜ結ぶのか
それぞれが答える問いは違う
ログは「その時点でアプリが何を記録したか」を残します。たとえば注文登録で決済先からエラーが返った場合、レスポンスの分類や業務上の判断はログに書けます。一方、トレースはHTTP受信から外部APIやDB呼び出しまでの処理区間と親子関係を見せます。ログの内容だけでは前後の待ち時間を、トレースだけでは独自の業務判断を読み切れない場合があります。
時刻とサービス名だけでログとトレースを突き合わせると、同時に多数のリクエストが走る環境では別人の処理を取り違えます。両方に同じTrace IDを持たせると、少なくとも同じトレースに属するデータを絞れます。ただし、IDが同じだけでログ収集や画面間のリンクが自動でできるわけではありません。
実務では「エラーログから該当Traceを探す」「遅いSpanの時刻に近いログを読む」という往復が役立ちます。最初は一つのAPIと一つのログ行で照合を試し、検索手順が再現できてから対象サービスを広げます。
Trace IDとSpan IDの使い分け
Trace IDは処理全体で共有する識別子、Span IDはその中の一つの区間を指す識別子です。注文APIから在庫サービスを呼べば、伝播が正しく行われた同じ処理には共通のTrace IDが付きますが、各サービスの受信や外部送信のSpan IDは異なります。
ログ検索の入口にはTrace IDが便利です。大量のログのうち特定のDB呼び出し区間を見たい場合は、Span IDも併記すると区間を狭められます。ただし、どのSpanが「現在のSpan」になるかはログが出された実行位置によるため、ログ行のSpan IDが常に画面上で期待したHTTPサーバーSpanと一致するとは限りません。
HTTPヘッダーのtraceparentはサービス間でトレースの文脈を運ぶためのものです。ログに単にヘッダーの文字列を貼る方法とは分け、実行中のSpanから得られるIDをログへ記録する方法を基本にします。入力ヘッダーをそのまま信用して監査用IDとして使う設計も避けます。
2. Java AgentとMDCの関係
MDCはログイベントへ文脈を渡す
MDC(Mapped Diagnostic Context)は、ログイベントへ付けるキーと値の情報です。Logbackなら出力パターンに%X{trace_id}や%mdc{trace_id}を指定して、イベントが持つ値を表示できます。単にトレースを生成するだけでは、既存のログパターンにこの項目は現れません。
OpenTelemetry Java AgentのLogger MDC自動計装は、現在のSpanからtrace_id、span_id、trace_flagsをロギングイベントのMDCコピーへ追加します。Logbackや対応するLog4j系など、使用中のライブラリが対象か公式の対応表を確認してください。別のロギング構成へ同じ書式をそのまま流用できるとは限りません。
ここでのMDC連携は、ログをOTLPで転送するappenderとは別の機能です。既存の標準出力ログへIDを表示するだけなら、ログエクスポートの経路を新設しなくても検証できます。その後、ログ収集基盤が表示したIDを検索フィールドとして認識するよう設定します。
MDC.get()と表示用データを混同しない
Java AgentのLogback MDC計装は、Logbackがappenderやencoderへ渡すイベントのMDCマップへ値を足します。アプリコードが読むSLF4JのスレッドローカルMDCへ同じ値を書き込む実装ではありません。このため、パターンにはTrace IDが表示されても、MDC.get("trace_id")はnullになり得ます。
これは故障と即断できない重要な違いです。ログ表示が目的ならまず出力された行を確認し、アプリのロジック内でIDを使う必要があるならOpenTelemetry APIの現在のSpanContextを検討します。手動で別のMDCへIDを重複設定すると、処理終了時の消し忘れやスレッド再利用による取り違えにも注意が必要です。
また、現在のSpanが無効な場面ではトレース情報は付与されません。アプリ起動時のログやリクエストと無関係な定期処理の行でIDが空でも、リクエスト中の行まで失敗しているとは限りません。
3. Logbackで実際に出力する
Spring Bootの出力パターン例
OpenTelemetry Java Agentで計装したSpring BootアプリがLogbackを使う場合、公式の例ではlogging.pattern.levelへMDCの参照を加えます。次のapplication.propertiesはログレベル表示付近へTrace IDとSpan IDを加える例です。
logging.pattern.level=trace_id=%mdc{trace_id} span_id=%mdc{span_id} %5pアプリをAgent付きで起動し、実在するHTTP APIを一度呼び、処理中に出たアプリログを見ます。trace_id=...とspan_id=...の値が表示されること、同じリクエスト中の複数行でTrace IDが一致することを確かめます。...は説明上の省略であり、実際のIDは規格に沿った長さの16進数です。
プロジェクトが独自のlogback-spring.xmlを持ち、console appenderの<pattern>を直接定義している場合は、その出力パターンにMDC項目を入れます。Spring Bootの設定値が既存のカスタムパターンへ必ず反映されると決めつけず、実際に使用されるappenderを見てください。
ログの出力から検索までを通す
標準出力の一行にIDが見えても、集約先で検索できないなら運用で使いにくいままです。ログ収集側がtrace_idを別フィールドとして抽出するか、少なくとも文字列で完全一致検索できることを確認します。トレース側では同じ環境とサービスの該当Trace IDを検索します。
たとえば注文APIで意図的にエラーを発生させ、ログに記録されたIDをコピーしてトレース画面で照合します。見つかったら同じ時刻帯のSpanを確認し、HTTP受信、外部通信、DBアクセスのどこでエラーや遅延が生じたかを調べます。これは観測の接続確認であって、業務エラーそのものの原因をIDだけで特定したことにはなりません。
集約ログの整形、IDの大文字小文字、フィールド名の変更、複数環境の混在で検索が失敗することがあります。最初に原本のログ行と取り込み後のレコードを比較し、どこでIDが欠けたかを切り分けるのが近道です。
4. Trace IDが空になる主な場面
Spanの外側で出したログ
HTTPリクエストが始まる前の起動ログや、リクエスト処理が終わってから別の非同期タスクで出したログには、現在のSpanがありません。MDC計装はその場で有効なSpanの文脈を使うので、存在しないIDを埋めることはできません。
非同期処理やキューへ仕事を渡す場合、元のリクエストとの関連を保つには、利用する実行基盤でのContext伝播を確認します。HTTP間の伝播ができていても、任意のスレッド生成や独自のキュー処理に自動で文脈が届くとは限りません。ログが出る処理の境界と、Spanが有効な時間を図にして確認します。
空欄のログを見つけたら、同じリクエスト内で確実に出すログとの比較を先に行います。全行が空なのか、一部の実行経路だけ空なのかで、出力パターンとContext伝播のどちらを調べるべきかが変わります。
計装・出力・収集を分けて確認する
トレース画面にSpanがない場合は、まずAgentの起動、対応ライブラリ、トレースのexport先を確認します。SpanはあるのにアプリログのID欄が空なら、使用中のログライブラリ、MDC計装、パターン、ログ出力位置を確認します。ログ原本にはIDがあり集約後にないなら、収集・パーサーの問題です。
確認対象を混ぜると「Collectorが悪い」といった推測に流れます。アプリの標準出力、トレースの受信側、ログ収集側の三つの地点で、同じ試験リクエストを比較してください。複数サービスなら各サービスのservice.nameも合わせます。
特にAgentのMDC機能だけでログとトレースの両方が自動で保存されるわけではありません。ログをどこへ保存するかとトレースをどこへ送るかは別の経路です。片方の経路が停止しているなら同じIDでも画面間の照合は成立しません。
5. 運用時の注意点
検索しやすさと機密情報を両立する
Trace IDは検索の鍵であり、ユーザーIDや注文IDの代用品ではありません。通常のログと同様にアクセス権限と保存期間を設計し、URL、HTTPヘッダー、属性、ログ本文へ機密情報が混ざらないか確認します。
特にMDCへ任意のbaggage情報を出す設定は、下流へ伝播する値をログにも写す可能性があります。公式設定ではbaggageをMDCへ追加する機能は既定で無効です。有効化する前に、キーと値に個人情報や認証情報が入らないことをレビューします。
運用手順には「ログ行のTrace IDを完全一致で検索し、該当サービスと時刻で絞る」「トレースが見つからない場合はサンプリング、保存期間、送信経路も確認する」と書くと、新人も同じ調査を再現できます。
サンプリングがある環境での限界
ログへTrace IDが出ていても、対応するトレースが必ず保存されるとは限りません。トレースのサンプリングで保存対象から外れたり、バックエンドへの送信が失敗したりすると、ログ側のIDだけが残ることがあります。
逆にSpanがあっても、その区間でアプリログが一行も出ていなければログ側に対応する行はありません。相関機能の成功率を評価するときは「試験したリクエストのうち両方が確認できた数」と条件を明示し、ログの欠落とサンプリングによる不在を区別します。
問い合わせ対応では、特定の取引のTraceが見えないことを「処理が存在しなかった証拠」と扱わないでください。ログ、業務DB、トレースには異なる保存方針と欠落条件があります。
6. 導入時の確認手順
一つのリクエストで検証する
開発環境ではまずAgentのトレースを一時的に全件記録し、LogbackのMDCパターンを有効にします。対象APIを一回呼んで、その処理中にログが出ること、ログ行にTrace IDが表示されること、トレース側にも同じIDがあることを確認します。
確認が終わったら通常のサンプリングや転送設定に戻し、同じ試験を繰り返します。戻した後だけ見つからないなら、MDCではなくサンプリングや受信側の条件を疑うべきです。負荷やデータ量を考え、本番で全件記録へ安易に切り替えないようにします。
複数サービス間では、入口サービスのログと下流サービスのログに同じTrace IDが付くこと、トレース画面上でサービス間の親子関係が追えることを確認します。異なるIDならサービス境界でのContext伝播を点検します。
調査手順をチームへ残す
ログ検索のフィールド名、トレース画面の検索方法、対象環境、保存期間を短い運用メモにします。トレースIDの形式や表示フィールドが環境で異なるなら例を添えます。インシデント中に初めて探し方を考える状態を避けられます。
さらに、特定のログがSpanの有効範囲外で空欄になることや、サンプリングでTraceが存在しない場合があることも記します。空欄をすべて障害と判定すると不要な調査が増えます。
最後に、ログへのID付与を成功条件として完了せず、実際のエラー行から検索画面を往復できるかを確認してください。これが運用で役に立つ最小単位です。
まとめ
Trace IDをログへ表示し、同じIDでトレースを探せると、業務上の出来事と処理経路を結び付けられます。Java AgentとLogbackのMDC連携では、ログパターンの設定と有効なSpanが必要です。出力元、ログ収集、トレース受信を別々に確認し、サンプリングや保存期間の影響も踏まえて検索手順を整えましょう。