仮想スレッドは、処理そのものを高速化する仕組みではなく、多数のタスクがI/O完了を待つ間に少数のOSスレッドをほかの仕事へ回しやすくする仕組みです。そのため性能評価では、通信やDBアクセスのように待ち時間が長い処理と、計算を続けるCPU中心の処理を分ける必要があります。本記事ではJava 25で同じ仕事量を実行し、経過時間とスループットの実測値から、仮想スレッドが効く条件と効かない条件を判断します。
掲載する値は、特定のPC上で再現用プログラムを実行した結果です。製品や環境を横断した優劣を断定するものではありません。コード、タスク数、ウォームアップ回数、生の計測値を示すので、自分の環境でも実行し、実際のHTTPクライアントやJDBC処理を使った負荷試験へ進むための基準にしてください。
1. 仮想スレッドの性能を何で判断するか
1.1 速さと処理能力を分ける
一件の処理が始まってから終わるまでの時間はレイテンシです。一定時間に完了できる件数はスループットです。仮想スレッドが主に改善するのは、多数の待機を同時に扱えることによるスループットであり、一件の処理内部にある100ミリ秒のネットワーク待ちを10ミリ秒へ短縮するものではありません。
たとえば外部APIが必ず100ミリ秒で応答するなら、仮想スレッドへ変えてもAPI自体の応答は100ミリ秒です。しかし、100件ずつしか同時に待てない構成から1,000件を同時に待てる構成へ変われば、1,000件全体の完了時間は短くなる可能性があります。一件の速度ではなく、同時に進められる要求数が変わった結果です。
性能表では、少なくとも次の値を分けます。
| 指標 | 表すもの | 読み方 |
|---|---|---|
| 経過時間 | 全タスクが終わるまでの時間 | 同じ仕事量で比較する |
| スループット | 1秒あたりの完了タスク数 | 高いほど多く処理できる |
| 一件のレイテンシ | 個々のタスクの開始から終了まで | p50だけでなくp95・p99も見る |
| CPU使用率 | 計算資源を使っている割合 | 高いままならスレッド変更だけでは伸びにくい |
| 待機中件数 | I/Oや資源を待つタスク数 | 増え続けるなら下流制限も調べる |
| メモリ・GC | タスクや入力が保持する量 | 軽量スレッドでも業務データは残る |
本記事の簡易プログラムは全タスクの経過時間とスループットを測ります。本番判断では、個々のレイテンシ分布、CPU、ヒープ、GC、DB接続待ちなどを追加してください。
1.2 I/O待ちとCPU処理を混ぜない
仮想スレッドは、ブロッキングI/Oなどで停止したときにキャリアとなるプラットフォームスレッドから外れ、別の仮想スレッドがそのキャリアを利用できるようにします。この性質は、待っている時間が長い仕事で効果を発揮します。
CPU処理中の仮想スレッドはキャリア上で実行されています。同時に計算できる量はCPUコア数に制約されるため、仮想スレッドを大量に作ってもCPUそのものは増えません。スケジューリング対象だけが増え、処理内容によっては切り替えの負荷が加わります。
実際のWeb要求には、JSON変換、認証、DB待ち、業務計算、外部API待ちなどが混在します。混合した一つのシナリオだけを測ると、どの区間が結果を決めたか分かりません。最初にI/O待ち中心とCPU中心の小さな試験を分け、その後に実サービスに近い混合負荷を測る順番が安全です。
2. 比較条件を固定する
2.1 同じタスクを二種類のExecutorへ渡す
比較では、タスクの内容、件数、入力を同じにし、Executorだけを変えます。プラットフォームスレッド側はExecutors.newFixedThreadPool、仮想スレッド側はExecutors.newVirtualThreadPerTaskExecutorを使います。
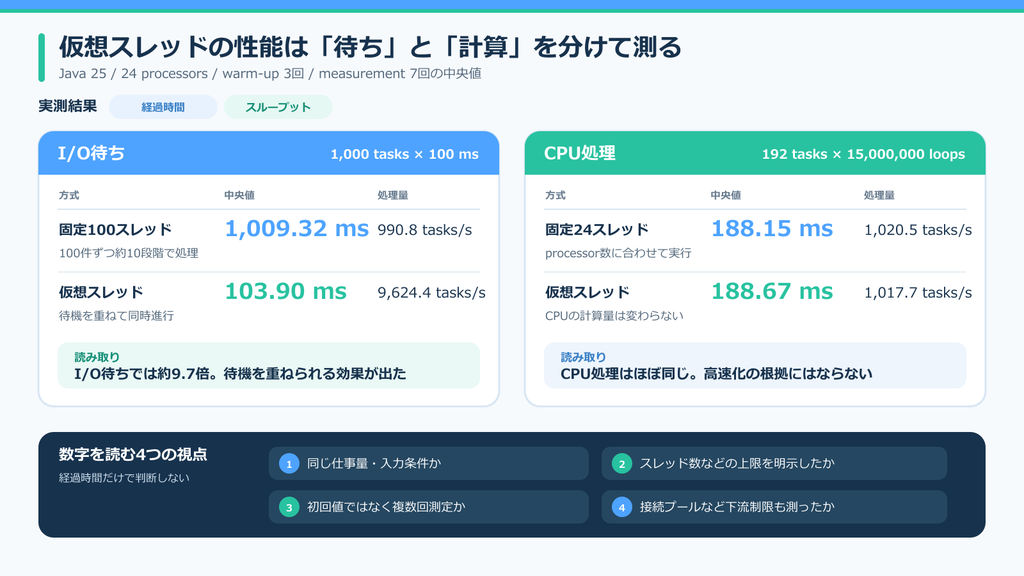
I/O待ちの再現には、1,000タスクが100ミリ秒ずつThread.sleepする処理を使います。sleepは実ネットワークではありませんが、仮想スレッドが待機中にキャリアを占有し続けない性質を確認しやすい方法です。固定プールは100スレッドとしたため、理論上は100件ずつ10段階で進み、全体で約1秒かかります。
CPU処理は、この環境で利用可能なプロセッサ数24に対して192タスクを作り、各タスクで同じ整数演算を1,500万回行います。固定プールのスレッド数は24です。戻り値を合計してvolatile変数へ保存し、計算結果が使われないことを理由に処理全体が除去されにくい形にします。
| 条件 | I/O待ち | CPU処理 |
|---|---|---|
| Java | Temurin 25.0.4.1 LTS | 同左 |
| 利用可能プロセッサ | 24 | 24 |
| タスク数 | 1,000 | 192 |
| タスク内容 | 100msの待機 | 整数演算を1,500万回 |
| 固定プール | 100スレッド | 24スレッド |
| 仮想スレッド | タスクごとに1本 | タスクごとに1本 |
| ウォームアップ | 3回 | 3回 |
| 計測 | 7回の中央値 | 7回の中央値 |
固定プールの100という値は比較条件であり、一般的な推奨値ではありません。500へ増やせばI/O待ちの完了時間は短くなる可能性がありますが、OSスレッドのスタック、スケジューリング、メモリなどの負担も変わります。値を変えたら別の条件として記録します。
2.2 初回だけを結果にしない
JVMでは、クラスの読み込みやJITコンパイルなどにより初回と継続実行の条件が異なります。そのためプログラムは各条件を3回ウォームアップしてから7回測り、並べ替えた中央の値を採用します。平均値だけを使うと、一時的なOS処理やバックグラウンド負荷による極端な値へ引っ張られることがあります。
簡易計測は、仮説を確かめる入口としては有効ですが、ナノ秒単位の処理や小さなメソッドの比較には不十分です。JITによる最適化、定数畳み込み、デッドコード除去、GC、CPU周波数などを扱うマイクロベンチマークでは、OpenJDKのJMHを使います。JMHでもウォームアップ、測定反復、fork、出力値の消費を設計しなければなりません。
本記事では一回あたり約0.1〜1秒の並行タスク群全体を測るため、仕組みが見える単独プログラムを採用しました。結果を製品選定や容量計画へ使う場合は、専用の負荷生成環境、複数プロセス、実際の下流サービス、十分な実行時間で再測定してください。
3. 再現用プログラムを実行する
3.1 計測コードの全体像
次のコードはJava 25でコンパイルできます。measureはウォームアップ後に7回実行し、経過時間をソートして中央値と1秒あたりの完了件数を表示します。各回でExecutorを新しく作り、try-with-resourcesによって全タスク終了後に閉じます。
import java.time.Duration;
import java.util.ArrayList;
import java.util.Arrays;
import java.util.List;
import java.util.concurrent.Callable;
import java.util.concurrent.ExecutorService;
import java.util.concurrent.Executors;
import java.util.concurrent.Future;
import java.util.function.Supplier;

public class VirtualThreadBenchmark {
    private static final int WARMUP = 3;
    private static final int RUNS = 7;
    private static volatile long sink;

    public static void main(String[] args) throws Exception {
        int processors = Runtime.getRuntime().availableProcessors();
        System.out.printf("Java=%s, processors=%d%n",
                System.getProperty("java.version"), processors);

        measure("I/O wait / platform(100)",
                () -> Executors.newFixedThreadPool(100),
                ioTasks(1_000, Duration.ofMillis(100)));
        measure("I/O wait / virtual",
                Executors::newVirtualThreadPerTaskExecutor,
                ioTasks(1_000, Duration.ofMillis(100)));

        int cpuTasks = processors * 8;
        measure("CPU / platform(" + processors + ")",
                () -> Executors.newFixedThreadPool(processors),
                cpuTasks(cpuTasks, 15_000_000));
        measure("CPU / virtual",
                Executors::newVirtualThreadPerTaskExecutor,
                cpuTasks(cpuTasks, 15_000_000));
        System.out.println("sink=" + sink);
    }

    private static List<Callable<Long>> ioTasks(int count, Duration delay) {
        List<Callable<Long>> tasks = new ArrayList<>(count);
        for (int i = 0; i < count; i++) {
            tasks.add(() -> {
                Thread.sleep(delay);
                return 1L;
            });
        }
        return tasks;
    }

    private static List<Callable<Long>> cpuTasks(int count, int loops) {
        List<Callable<Long>> tasks = new ArrayList<>(count);
        for (int task = 0; task < count; task++) {
            final int seed = task;
            tasks.add(() -> {
                long value = seed + 1L;
                for (int i = 0; i < loops; i++) {
                    value = value * 1_664_525L + 1_013_904_223L;
                    value ^= value >>> 17;
                }
                return value;
            });
        }
        return tasks;
    }

    private static void measure(String label,
            Supplier<ExecutorService> factory,
            List<Callable<Long>> tasks) throws Exception {
        for (int i = 0; i < WARMUP; i++) {
            runOnce(factory, tasks);
        }
        long[] times = new long[RUNS];
        for (int i = 0; i < RUNS; i++) {
            times[i] = runOnce(factory, tasks);
        }
        Arrays.sort(times);
        double medianMs = times[RUNS / 2] / 1_000_000.0;
        double throughput = tasks.size() / (medianMs / 1_000.0);
        System.out.printf(
                "%-25s median=%8.2f ms, throughput=%8.1f tasks/s, all=%s%n",
                label, medianMs, throughput,
                Arrays.toString(Arrays.stream(times)
                        .map(t -> t / 1_000_000).toArray()));
    }

    private static long runOnce(Supplier<ExecutorService> factory,
            List<Callable<Long>> tasks) throws Exception {
        long start = System.nanoTime();
        long sum = 0;
        try (ExecutorService executor = factory.get()) {
            List<Future<Long>> futures = executor.invokeAll(tasks);
            for (Future<Long> future : futures) {
                sum += future.get();
            }
        }
        sink = sum;
        return System.nanoTime() - start;
    }
}System.nanoTime()は経過時間の差を測るために使います。現在日時を表す値ではありませんが、端末時刻の補正に影響されにくいため、同一プロセス内の時間差に向いています。
3.2 実行条件を結果と一緒に保存する
実行は次のように行います。
javac VirtualThreadBenchmark.java
java VirtualThreadBenchmark結果だけを表計算へ転記するのではなく、java -version、OS、CPU、利用可能プロセッサ数、JVMオプション、ソースコードのコミット、実行日時を残します。同じPCでも省電力設定、同時に動くアプリ、温度、ウイルススキャンなどで値は変わります。
コンテナで測る場合は、ホストのCPU数とコンテナへ設定したCPU上限も確認します。availableProcessors()が想定と異なると、固定プールのサイズや仮想スレッドのスケジューラ並列度へ影響します。クラウド環境では、共有CPUのバーストやスロットリングも結果へ含まれます。
4. I/O待ちの結果を読む
4.1 仮想スレッドは約10倍の完了件数になった
この環境で得た結果は次のとおりです。allはソート後の各回の経過時間で、単位はミリ秒です。
Java=25.0.4.1, processors=24
I/O wait / platform(100)  median=1009.32 ms,
  throughput=990.8 tasks/s,
  all=[1006, 1007, 1008, 1009, 1009, 1009, 1009]
I/O wait / virtual        median=103.90 ms,
  throughput=9624.4 tasks/s,
  all=[101, 102, 103, 103, 104, 104, 104]
固定100スレッドでは、1,000タスクが約100件ずつ進むため、100ミリ秒の待機が約10段階必要です。Executorの作成やタスク管理を含め、中央値は約1,009ミリ秒になりました。仮想スレッドでは1,000タスクがそれぞれ待機でき、全体は約104ミリ秒で完了しました。
スループットは約991件/秒から約9,624件/秒へ上がり、この条件では約9.7倍です。ただし「仮想スレッドは常に9.7倍速い」とは解釈できません。固定プールを100に制限した比較であり、待機時間、タスク数、CPU、JDK、OSを変えれば倍率も変わります。
一件のThread.sleep(100ms)が約10msになったわけでもありません。全体の待機を重ねられたため、1,000件の終了時刻が近づきました。ここを区別すると、利用者一人の応答時間と、ピーク時に処理できる利用者数を混同せずに済みます。
4.2 実I/Oでは下流の上限が結果を決める
Thread.sleepには接続プール、ソケット、相手サービス、帯域、レート制限がありません。実際のDBアクセスを1,000件同時に開始しても、接続プールが20なら、最大20件しかDBへ入りません。外部APIが同時50件までなら、それを超える要求は遅延や拒否の原因になります。
仮想スレッドへ変えた結果、アプリ内の固定スレッドプールによる待ちが減り、次の制限が目立つことがあります。これは異常ではなく、ボトルネックがDB接続、外部API、帯域など本来の有限資源へ移った状態です。接続プールやSemaphoreで下流を守り、取得待ち時間と実処理時間を別々に測ります。
実サービスの負荷試験では、入力レートを段階的に上げ、スループットが頭打ちになる点、p95・p99、タイムアウト、エラー、CPU、メモリ、下流の指標を同じ時間軸で確認します。成功件数だけを見て、失敗した要求や異常に遅い要求を除外しないでください。
5. CPU処理の結果を読む
5.1 仮想スレッドへ変えても計算は速くならなかった
同じ実行でCPU処理は次の結果になりました。
CPU / platform(24)  median=188.15 ms,
  throughput=1020.5 tasks/s,
  all=[186, 186, 187, 188, 188, 189, 194]
CPU / virtual       median=188.67 ms,
  throughput=1017.7 tasks/s,
  all=[185, 188, 188, 188, 189, 193, 194]
固定24スレッドは約188.15ミリ秒、仮想スレッドは約188.67ミリ秒で、差は約0.3%でした。この程度の差はバックグラウンド負荷や測定揺れでも変わり得ます。この結果から優劣を断定するのではなく、「このCPU中心の仕事では仮想スレッドによる明確な短縮を確認できなかった」と読みます。
利用可能なプロセッサが24なら、同時にCPUで計算できる量には上限があります。192本の仮想スレッドを作っても、192タスクが物理的に同時実行されるわけではありません。実行可能な仮想スレッドはスケジューラ上で順番を待ちます。
CPU中心の処理を速くしたい場合は、アルゴリズム、データ構造、割り当て量、ベクトル化、並列分割、キャッシュ効率などを調べます。タスクを無制限に分割すると、管理と切り替えの負荷が増え、かえって遅くなる可能性があります。
5.2 CPU処理を仮想スレッドで実行してはいけないわけではない
仮想スレッドのタスクに短いCPU処理が含まれること自体は普通です。Web要求は入力検証やJSON変換を行い、その後にI/Oを待ちます。「CPU命令を一つでも実行するなら不適切」という意味ではありません。
問題になるのは、長時間CPUを使い続けるタスクを大量に作り、仮想スレッド化だけで処理能力が伸びると期待することです。CPU負荷が支配的なら、入力を受け付ける量を制限し、必要に応じてCPU向けの並列度を明示します。処理の大半がI/O待ちで、短い計算を挟むなら、タスクごとの分かりやすい同期コードを維持できる利点があります。
判断にはCPU使用率と待機時間を使います。CPUが常に上限近く、実行待ちが増えるなら計算側が候補です。CPUに余裕があるのに要求が多数I/O待ちなら、仮想スレッドが適合する可能性が高くなります。
6. 誤ったベンチマークを避ける
6.1 比較対象の上限を隠さない
固定プールを小さく設定して仮想スレッドだけを大きく見せる、または固定プールを極端に大きくしてOSへ負担を寄せる比較では、実務判断につながりません。固定プールのサイズ、その根拠、接続上限、入力件数を明記します。
タスク生成時間を含めるかも揃えます。本記事はExecutor作成、タスク投入、完了待ち、終了を一回の経過時間に含めました。処理中だけを測るなら、両方式で同じ範囲を切り出します。ログ出力をループ内へ入れると、コンソールI/Oやロックが結果を支配するため、計測中の詳細ログは避けます。
異なる処理結果を比較してはいけません。片方だけキャッシュを利用したり、例外で途中終了したり、タイムアウトした要求を成功件数から除いたりすると、短い経過時間でも同じ仕事を完了していません。結果の合計や件数を検証し、エラーがないことを確認します。
6.2 sleepの結果を本番性能として扱わない
Thread.sleepは待機を再現するものであり、ネットワークやDBの性能モデルではありません。実I/Oでは、接続確立、TLS、名前解決、サーバ処理、レスポンスサイズ、帯域、再送、プール待ちが関係します。クライアントライブラリが仮想スレッド上のブロッキング操作へどう対応するかも確認が必要です。
次の段階では、ステージング環境の読み取り専用APIなど安全な対象を使い、固定レートで負荷を発生させます。本番データ更新を伴う処理へいきなり大量負荷をかけないでください。外部サービスには負荷試験の許可と上限を確認します。
測定結果をレビューするときは、次の表を埋めます。
| 確認項目 | 記録する内容 |
|---|---|
| 目的 | スループット、レイテンシ、資源量のどれを改善したいか |
| 環境 | JDK、OS、CPU、メモリ、コンテナ制限 |
| 負荷 | 件数、到着率、同時数、継続時間 |
| 仕事量 | I/O先、データ量、CPU処理、成功条件 |
| 上限 | 固定プール、DB接続、外部API、Semaphore |
| 手順 | ウォームアップ、反復、中央値・分位点 |
| 結果 | 成功、失敗、時間切れを含む生データ |
| 資源 | CPU、ヒープ、GC、接続、待機数 |
7. 実務で採用を判断する
7.1 小さな実測から本番に近い負荷へ広げる
最初に、本記事のような制御された試験で「I/O待ちを重ねられること」と「CPUは速くならないこと」を確認します。次に、一つのHTTPまたはJDBC処理を対象にし、固定プールと仮想スレッドで同じ要求列を流します。最後に、認証、業務処理、複数の下流、タイムアウトを含む経路を測ります。
段階を飛ばしてアプリ全体だけを測ると、改善も悪化も原因を説明できません。一方、小さな試験だけで本番採用を決めると、下流制限やメモリ保持を見落とします。小さい試験は仕組みの確認、本番に近い試験は容量と運用の確認という役割分担にします。
採用基準は「仮想スレッドの値が勝った」だけにしません。コードが単純になったか、タイムアウトとキャンセルを扱えるか、接続上限を守れるか、障害時に観測できるかも含めます。性能差が小さくても、スレッド不足を避けながら同期コードを維持できる価値がある場合があります。
7.2 数字の意味を一文で説明できる状態にする
報告では、倍率だけでなく条件と理由を一文で説明します。たとえば「100ミリ秒待つ1,000タスクを固定100スレッドで10段階に処理したため約1秒、仮想スレッドでは待機を重ねられたため約0.1秒」と書けば、結果の範囲が分かります。
CPU結果なら「24プロセッサで同じ整数演算を行い、両方式とも中央値約188ミリ秒で、仮想スレッドによる計算時間の短縮は確認できなかった」と表現できます。「仮想スレッドは10倍高速」「CPUには使えない」のような条件を欠く断定を避けられます。
測定値を残す際は、ソースコードと生データも一緒に保管します。後からJDKを更新したとき、設定を変えたとき、異なるクラウドインスタンスへ移したときに同じ手順で比較できます。再現できることが、単発の速い数字より重要です。
まとめ
仮想スレッドの性能は、I/O待ちとCPU処理を分けて測る必要があります。本記事のJava 25での実測では、100ミリ秒待つ1,000タスクが固定100スレッドで約1,009ミリ秒、仮想スレッドで約104ミリ秒でした。待機を重ねられたため全体スループットが約9.7倍になった結果であり、一件のI/O自体が高速化したわけではありません。
CPU中心の同一処理は両方式とも約188ミリ秒で、明確な短縮はありませんでした。仮想スレッドはCPUを増やす仕組みではないためです。環境、仕事量、上限、ウォームアップ、生データを残し、実I/Oでは接続プールや外部サービスの能力も含めて測ってください。条件を説明できる計測にすることで、流行や印象ではなく、対象システムに仮想スレッドが合うかを判断できます。