OpenTelemetryのトレースサンプリングは、発生した処理のうち、どのトレースを記録・転送・保存するかを選ぶ仕組みです。全件保存は障害調査に必要な情報を幅広く残せる一方、アクセス数やSpan数に比例してデータ量と費用が増加します。サンプリングを利用すれば、調査に必要な情報を一定程度確保しながら、監視基盤の負荷や保存費用を抑えられます。
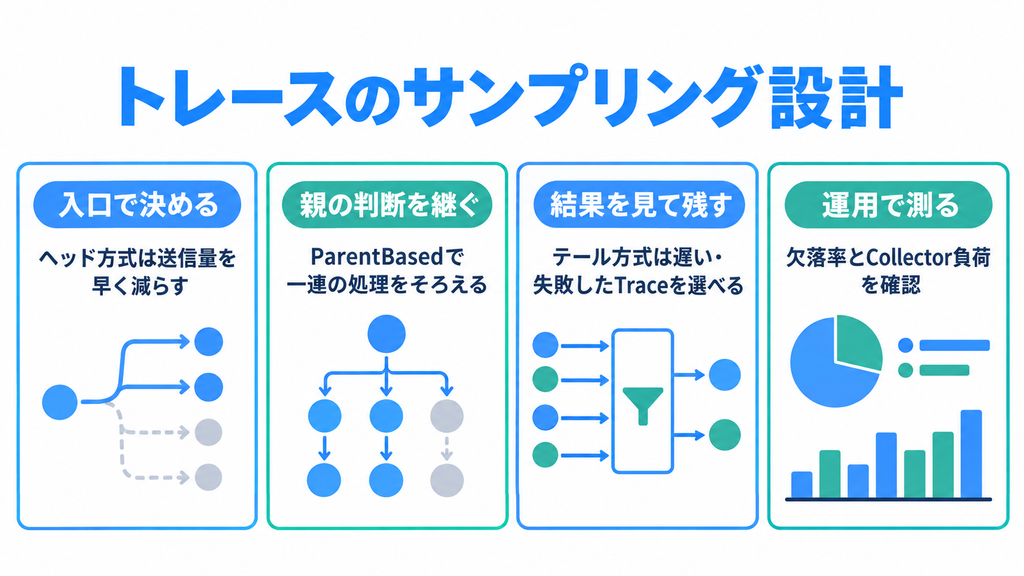
代表的な方式には、処理の開始時点で判断するヘッドサンプリングと、SpanがCollectorへ届いた後に判断するテールサンプリングがあります。ヘッド方式は早い段階でデータ量を減らせますが、後から発生するエラーや遅延を判断材料にできません。テール方式は処理結果に応じた選別が可能な一方、Collector側でデータを一時的に保持するため、メモリ使用量や構成の複雑さが増します。どちらも「保存されなかったトレースは後から復元できない」ことを踏まえ、保存費用だけでなく、障害調査で必要な情報を残せるかという観点から設計する必要があります。
1. なぜサンプリングが必要か
全件保存の価値と費用
トレースは、一つのリクエストに対して複数のSpanを生成します。たとえば注文APIが在庫確認、決済処理、DB更新を順番に実行する構成では、それぞれの処理やサービス間通信に対応するSpanが作られます。一回のリクエストでも多くのSpanが発生するため、アクセス数が増えるほど収集対象のデータも増加します。
Spanには、処理の開始・終了時刻、処理名、Status、属性、イベントなどの情報が含まれます。これらは障害原因を調べるうえで重要ですが、Spanごとに一定のデータ量が発生します。さらに、OpenTelemetry SDKやAgentからCollectorへの転送、Collector内部での処理、バックエンドへの送信、保存といった各段階でリソースを消費します。
たとえば、一日に100万件のリクエストがあり、一件あたり平均10個のSpanが生成される場合、一日あたり約1,000万個のSpanが発生する計算です。Spanのサイズを仮に平均1KBとすると、単純計算で一日約10GB、30日間では約300GBのデータになります。実際の容量はエンコード形式、圧縮、付加情報、保存基盤の内部構造などによって変わりますが、リクエスト数とSpan数がデータ量に与える影響を把握する目安になります。
全件保存は、まれにしか発生しない障害や、数日前の処理について問い合わせがあった場合に強い方法です。保存されていれば、事前に予測できなかった問題についても、当時のサービス間通信や処理時間を確認できます。一方、ヘルスチェックや定期的な状態確認など、大量に発生する正常リクエストまで同じ期間・同じ粒度で保存する必要があるかは別の判断です。
また、データ量の増加は費用だけの問題ではありません。大量の正常なTraceが蓄積されると、検索対象が増え、調査したい処理を見つけるまでに時間がかかる場合があります。バックエンドの性能や検索条件によっては、保存容量の増加が検索応答時間にも影響します。
サンプリングを検討する際は、まず一日のリクエスト量、要求あたりのSpan数、平均データサイズ、保存期間を測定します。そのうえで、どの種類のTraceを優先して残すべきかを整理します。最初から「10%だけ保存する」と決めても、必要な障害情報をどれだけ確保できるかは判断できません。
抽出率は調査可能性と交換する
サンプリングで除外されたトレースは、バックエンドで検索できません。たとえば100件のリクエストから約10%を残す比率方式では、全体の保存量を減らせる一方、個別のリクエストが選ばれるとは限りません。単発で発生した障害がサンプリング対象から外れた場合、その処理のトレースを後から確認することはできません。
この性質は、正常な処理と異常な処理を区別せずに抽出する場合に特に重要です。たとえば通常のリクエストが一日に10万件あり、そのうち5件だけがエラーになったとします。全体から10%を抽出する設定では、正常な処理と同様にエラーとなった処理も選別されます。そのため、エラーの発生自体はログやメトリクスで確認できても、該当するTraceが一件も残っていない可能性があります。
また、トレースのサンプリングと、ログやメトリクスの収集は区別して考える必要があります。一般的なOpenTelemetryのトレースサンプリングは、トレースの記録や転送を制御する仕組みであり、ログとメトリクスを必ず同じ割合で削減するものではありません。
たとえばアプリケーションがエラーログを記録し、そのログにTrace IDを含めていた場合、ログから対象の処理を特定できることがあります。しかし、対応するトレースがサンプリングによって除外されていれば、Trace IDを使って検索しても結果が見つかりません。これは必ずしもデータ転送の障害ではなく、設定されたサンプリングが正常に動作した結果とも考えられます。
必要なデータを整理するときは、まず何を調査するためにトレースを保存するのかを明確にします。平均的な処理時間の傾向を把握したいのか、まれな500系エラーを追跡したいのか、複数サービスをまたぐ通信の問題を調べたいのかによって、許容できる欠落の範囲は異なります。
特に、金融システムの取引記録や監査証跡など、欠落を許容できない情報を確率的に抽出するトレースだけに依存させてはいけません。トレースは障害調査や性能分析を補助する観測データであり、業務上の記録を確実に保存する仕組みとは役割が異なります。
2. ヘッド方式の仕組み
処理の入口で判断する
ヘッドサンプリングは、通常、トレースの開始時点で記録するかどうかを決める方式です。判断に利用できるのは、その時点で取得できる情報やTrace IDなどです。処理の終了結果を待たずに判断するため、後続の処理で発生するエラーや遅延を条件にすることはできません。
代表的な方法が、一定の比率を目安にトレースを選ぶ比率サンプリングです。たとえば10%を指定した場合、Trace IDに基づく判断などによって、全体のおよそ10%を記録対象とします。選ばれなかった処理では、通常、記録・転送されるSpanを早い段階から減らせます。
この方式の利点は、アプリケーション側のデータ生成やネットワーク転送を抑えやすいことです。Collectorへ送信する前に記録対象を決められるため、大量のトラフィックが発生するサービスでも、後段へ流れるトレースデータを削減できます。バックエンドの保存量だけでなく、転送や収集処理の負荷を抑えたい場合にも有効です。
ただし、10%という設定は、連続した10件のうち必ず1件を記録することを意味しません。長期間にわたって多くのTraceを収集した場合の抽出割合を目安にしたものであり、少数のリクエストでは設定値と実際の割合が一致しないことがあります。
また、比率は正常な処理と異常な処理の区別を保証しません。注文APIで一日に数件しか発生しない決済エラーがあった場合、そのエラーに対応するTraceがすべて抽出対象から外れる可能性もあります。
ヘッドサンプリングでは、処理開始時点で記録対象から外したTraceについて、後からエラーが発生したことを理由に記録を開始することは基本的にできません。このため、ヘッド方式だけで「障害が発生した処理は必ず保存する」という要件を満たすことは困難です。
検証環境ではすべてのTraceが確認できるのに、本番環境で特定のTrace IDが見つからない場合は、まずサンプラーの種類と設定された比率を確認します。サンプリングによる正常な除外と、AgentやCollectorの送信障害による欠落は区別して調査する必要があります。
ParentBasedで親の判断を引き継ぐ
分散システムでは、複数のサービスが一つのリクエストに関わります。たとえばAPI Gatewayから注文サービス、決済サービス、DBへと処理が進む場合、それぞれのサービスでSpanが作られます。このとき、サービスごとに独立したサンプリング判断を行うと、一つのTraceのうち、一部のSpanだけが保存される可能性があります。
たとえば注文サービスでは記録対象となったものの、決済サービスでは記録対象から外れた場合、決済処理に関する詳細なSpanが欠落します。トレース画面には注文サービスの処理だけが表示され、決済サービス内部の処理時間やエラーを確認できないことがあります。
この問題を抑えるために利用するのが、親のサンプリング判断を引き継ぐParentBasedサンプラーです。ParentBasedは、親Spanが存在する場合に、そのサンプリング判断を考慮して子Spanの記録を決定します。親が記録対象であれば子も記録し、親が記録対象外であれば子も記録しないという動作が基本になります。
parentbased_traceidratioは、親が存在しないルートSpanにTrace ID比率による判断を適用し、親がある場合には親の判断を引き継ぐ構成です。OpenTelemetryのSDKでは、環境変数を使用して次のように設定できます。
OTEL_TRACES_SAMPLER=parentbased_traceidratio \
OTEL_TRACES_SAMPLER_ARG=0.1 \
java -javaagent:/opt/otel/opentelemetry-javaagent.jar -jar app.jarこの設定では、親を持たないルートTraceについて、約10%を目安に記録対象を選びます。OTEL_TRACES_SAMPLERには使用するサンプラーの種類を指定し、OTEL_TRACES_SAMPLER_ARGには抽出率を指定します。0.1は10%を意味し、10ではありません。比率には0から1の範囲の値を使用します。
なお、このコマンドはOpenTelemetry Java AgentのJARファイルが指定した場所に存在することを前提としています。実際にトレースを転送するには、サービス名やOTLPの送信先など、環境に応じた設定も必要です。
ParentBasedを使用する場合は、サービス間でトレースのコンテキストが正しく伝搬していることも重要です。HTTP通信では、たとえばW3C Trace Contextのtraceparentヘッダーを使用して、Trace IDやサンプリング判断に関する情報を引き継ぎます。ヘッダーが正しく伝搬されなければ、下流サービスが新しいルートTraceとして処理を開始し、独立した判断を行う可能性があります。
また、すでに上流サービスから親のサンプリング判断が渡されている場合、下流サービスの10%という設定がそのまま適用されるとは限りません。ParentBasedは親の判断を優先するため、上流と下流でサンプリングポリシーが異なる構成では、実際の保存割合が想定と変わる可能性があります。
設定の検証では、単にTraceの件数を確認するだけでなく、一つのTraceに属する複数サービスのSpanが正しく関連付いているかを確認します。十分な数のリクエストを発生させ、抽出割合とTraceのつながりをそれぞれ検証することが重要です。
3. テール方式の仕組み
結果を見て残すか決める
テールサンプリングは、SpanがCollectorへ到着した後、一定時間に集まった情報を評価してTraceを保存するかどうかを決める方式です。ヘッド方式と異なり、処理開始時点では分からなかったエラーや所要時間を判断材料にできます。
たとえば、通常のリクエストは短時間で正常終了する一方、DB接続のタイムアウトが発生した処理では数秒以上かかる場合があります。テール方式では、ERROR状態のSpanを含むTraceや、一定時間を超えたTraceを優先して残すことができます。
この仕組みによって、正常な処理の保存量を抑えながら、障害調査に利用する可能性が高いTraceを残しやすくなります。特に、発生頻度の低いエラーや、通常より大きく遅延した処理を調査したい場合に有効です。
ただし、テールサンプリングが必ず処理の完全な終了を待って判断するわけではありません。一般的な構成では、Collectorが最初のSpanを受信してから一定時間待ち、その間に集まった情報を評価します。したがって、長時間処理や通信遅延などによって一部のSpanが判断後に到着した場合、その情報が当初の判定に反映されないことがあります。
また、エラーを保存するポリシーは、評価対象のSpanにエラーを識別できる情報が記録されていることが前提です。たとえばStatusがERRORのSpanを残す設定では、アプリケーションがエラーログを出力していても、Span StatusがERRORになっていなければ条件に一致しない場合があります。
HTTPステータスコードとSpan Statusも同じものではありません。HTTPの500系レスポンスや例外の発生がSpan Statusへどのように反映されるかは、使用する計装ライブラリや処理の役割によって異なります。障害を確実に判定したい場合は、実際に発生させたエラーについて、どのようなSpanが生成されるかを確認する必要があります。
テール方式では、Collectorがサンプリング判断を行う前にSpanを受信する必要があります。そのため、アプリケーションからCollectorまでの通信量をヘッド方式のように大幅に削減することはできません。削減できるのは主に、サンプリング判断後に送信するデータ量やバックエンドの保存量です。
Collectorのポリシー例
OpenTelemetry Collector Contribには、テールサンプリングを実行するtail_sampling processorが用意されています。このprocessorでは、Traceを保存する条件をポリシーとして定義します。
たとえば、正常な処理の大部分は保存せず、ERROR状態のSpanを含むTrace、または処理時間が5秒以上のTraceを残したい場合、次のような設定を利用できます。
processors:
  tail_sampling:
    decision_wait: 10s
    num_traces: 1000
    policies:
      - name: errors
        type: status_code
        status_code:
          status_codes: [ERROR]
      - name: slow
        type: latency
        latency:
          threshold_ms: 5000

service:
  pipelines:
    traces:
      receivers: [otlp]
      processors: [tail_sampling]
exporters: [otlp]この例では、tail_sampling processorに二つのポリシーを設定しています。
errorsポリシーは、Span StatusがERRORのTraceを抽出対象とします。type: status_codeを指定し、status_codesにERRORを設定することで、エラー状態を含むTraceを保存候補として扱います。
slowポリシーは、処理時間が一定のしきい値を超えたTraceを抽出対象とします。type: latencyを指定し、threshold_ms: 5000とすることで、5,000ミリ秒、つまり5秒以上のTraceを保存候補とします。この所要時間は、収集できたSpanの最も早い開始時刻と最も遅い終了時刻に基づいて評価されます。
この単純な設定では、いずれかのポリシーに一致すればTraceを保存対象とします。つまり、短時間で終了したエラーも、エラーが発生していない遅い処理も残すことができます。一方、どちらの条件にも一致しない正常な短時間処理は、原則として保存対象から外れます。
decision_wait: 10sは、サンプリング判断までの待機時間を指定する設定です。標準的な判断方式では、最初のSpanを受信してから一定時間の情報を集め、その後にポリシーを評価します。ただし、この10秒はTraceの完全性を保証する時間ではありません。
num_traces: 1000は、Collectorがメモリ内で保持するTrace数に関わる設定です。十分な容量を確保できなければ、判断前のTraceが保持領域から押し出される可能性があります。1,000という値は説明用であり、本番環境にそのまま適用できる固定の推奨値ではありません。
また、上記のYAMLはprocessorとパイプラインの関係を示す抜粋です。この設定だけでCollectorを起動できるわけではありません。実際には、OTLP receiverとexporterの定義、送信先、認証、TLS、使用するCollector配布版などを設定する必要があります。
さらに、テール方式でエラーや遅延を判断するには、必要なSpanがCollectorへ届いていることが前提です。SDK側ですでに大部分のTraceを除外している場合、Collectorは届かなかった処理を評価できません。テールサンプリングを主な選別方法とする場合は、上流のサンプリング設定も合わせて確認します。
4. 二つの方式を比較して選ぶ
費用と情報の違いを整理する
ヘッドサンプリングとテールサンプリングは、どちらもトレースのデータ量を減らす仕組みですが、判断するタイミングと利用できる情報が異なります。そのため、単純にどちらかが優れているという関係ではなく、削減したい負荷と調査したい内容に応じて使い分けます。
| 観点 | ヘッド方式 | テール方式 |
|---|---|---|
| 判断する時点 | 処理の開始時 | Span受信後、一定時間の情報を見て |
| 判断に利用できる情報 | 開始時点の情報やTrace IDなど | 到着したSpanのStatus、所要時間、属性など |
| エラー・遅延を条件にする | 後で分かる結果は判断できない | 対応するStatusや所要時間を条件にできる |
| アプリからCollectorへの量 | 入口から抑えやすい | 選別前のデータが届く |
| バックエンドへの保存量 | 抽出率に応じて削減できる | ポリシーに応じて削減できる |
| Collectorの負荷 | 比較的抑えやすい | 判断前のSpanの受信・保持が必要 |
| 運用上の注意 | 稀な障害が選ばれない可能性 | メモリ、到着遅延、同じTraceの集約が必要 |
アクセス数が多く、まずアプリケーションからの送信量を減らしたい場合は、ParentBasedとTrace ID比率を組み合わせたヘッドサンプリングが候補になります。構成が比較的単純で、処理開始時点から収集量を減らしやすいためです。
一方、アクセス全体の中でエラーが少なく、発生したエラーを優先的に調べたい場合は、テールサンプリングが適しています。たとえば決済APIの正常な処理は大量に発生するものの、タイムアウトや外部サービスの応答異常は少数しか発生しない場合、通常処理を間引いて異常な処理を優先的に残す設計が考えられます。
ただし、エラーを優先保存するためには、何をエラーと判断するかを定義しておく必要があります。単にHTTPステータスコードが500以上ならエラーとするのか、Span StatusがERRORの場合だけを対象とするのかによって、保存されるTraceは変わります。
また、遅延を条件にする場合も、どの程度の処理時間を異常とみなすかを決める必要があります。通常の処理時間が100ミリ秒程度のAPIと、数十秒かかるバッチ処理では、同じ5秒というしきい値でも意味が異なります。
サービスごとの処理特性を確認せずに一律のポリシーを適用すると、正常な長時間処理が大量に保存されたり、調査したい短時間のエラーが除外されたりする可能性があります。
最終的には、後段の保存費用だけが課題なのか、アプリケーションのCPUやネットワーク通信量も課題なのかによって選択が変わります。サンプリングを行う位置によって削減できるリソースが異なるため、システム全体の負荷を見て判断することが重要です。
組み合わせても欠落は戻らない
ヘッド方式とテール方式を組み合わせることもできます。ただし、両方を有効にしたからといって、それぞれの利点を完全に得られるわけではありません。特に重要なのが、前段で除外されたTraceは後段で復元できないという性質です。
たとえば、アプリケーション側のヘッドサンプリングで10%だけを記録し、Collector側ではERRORのTraceをすべて保存するポリシーを設定したとします。
この場合、Collectorが評価できるのは、ヘッドサンプリングで選ばれた約10%のTraceだけです。残りの約90%に含まれるエラーはCollectorへ届かないため、テールサンプリングで選択することはできません。
したがって、この構成で「全エラーを保存できる」と考えるのは誤りです。テール方式のエラー優先保存は、あくまでCollectorへ届いたTraceに対して行われます。
正常な処理を間引きつつエラーを優先的に残したい場合は、テールサンプリング側で複数のポリシーを組み合わせる方法もあります。たとえば、ERRORのTraceを選ぶstatus_codeポリシーと、一定割合のTraceを選ぶprobabilisticポリシーを組み合わせる構成です。
この方法であれば、Collectorが受信したTraceの中から、エラーを含むTraceを優先的に保存し、それ以外のTraceを一定割合で残す設計が可能です。ただし、前段のサンプリング、Collectorの処理能力、Spanの到着遅延などによって欠落が発生する可能性は残ります。
また、複数のポリシーを設定する場合は、単純なOR条件として評価できるものだけでなく、明示的に除外するdropポリシーなども存在します。除外条件がほかの保存条件より優先される構成もあるため、ポリシー間の関係を確認する必要があります。
併用する場合は、どの段階で何%を除外し、どの種類のTraceを優先的に保護したいのかを明示します。ヘッド方式の抽出率を高くすれば、Collectorへ届くエラーの割合も増えますが、その分ネットワークとCollectorの負荷も増加します。
バッチ処理や重要な取引など、記録の欠落を許容できない処理は、確率的なサンプリングとは別に考えます。監査ログや業務データとして必要な情報を確実に永続化し、トレースは処理の流れや性能を調査する補助情報として利用する設計が適切です。
5. テール方式を運用するときの落とし穴
同じTraceのSpanを同じCollectorへ送る
テールサンプリングでは、同じTrace IDを持つSpanをまとめ、その内容から保存するかどうかを判断します。そのため、一つのTraceに含まれるSpanが複数のCollectorインスタンスへ分散すると、各インスタンスがTrace全体の情報を取得できなくなる可能性があります。
たとえば注文サービスと決済サービスが別々のCollectorへSpanを送信する構成を考えます。注文サービスのSpanはCollector Aへ届き、決済サービスのSpanはCollector Bへ届いた場合、それぞれのCollectorは一部のSpanだけを使ってサンプリングを判断することになります。
もし決済サービスでエラーが発生していた場合、Collector BはERRORを確認できても、Collector Aはその情報を持っていません。結果として、同じTrace IDを持つSpanに対して異なる判断が行われ、保存されたTraceが不完全になる可能性があります。
OpenTelemetry Collector Contribの公式READMEでも、正しいテールサンプリングの判断を行うため、同じTraceに属するすべてのSpanを同じCollectorインスタンスへ送る必要があると説明されています。
単一インスタンスで動作確認した構成を、単純なラウンドロビン方式で複数台へ拡張すると、この問題が発生する可能性があります。ラウンドロビンは送信先を順番に切り替えるため、同じTrace IDに属するSpanが異なるCollectorへ送られることがあります。
対策として、Trace IDに基づいて送信先を決める方法があります。公式ドキュメントでは、load balancing exporterを利用し、同じTraceに属するSpanを同一のCollectorへ集約する構成が紹介されています。
たとえば、アプリケーションから送信されたSpanを前段のCollectorで受信し、Trace IDを使って後段のCollectorへ振り分けます。後段のCollectorでテールサンプリングを実行することで、同じTraceのSpanをまとめて評価できる構成です。
ただし、送信先を固定する仕組みを導入すれば、すべての問題が解消するわけではありません。Collectorの台数変更、障害による再配置、通信失敗などが発生した場合、同じTraceのSpanが途中から別のインスタンスへ送られる可能性もあります。
また、一台に集約しすぎるとメモリやCPUの負荷が集中します。処理能力を超えた場合には、Collector側でSpanの欠落が発生する可能性があります。Collectorが停止した場合の影響や、再起動時に保持中のTraceをどう扱うかも含めて検討する必要があります。
テールサンプリングを複数インスタンスで運用する際は、単にCollectorを増やすだけでなく、Trace単位での送信先の一貫性と、負荷分散の両方を確保することが重要です。
待機時間とメモリを測る
テールサンプリングでは、Collectorがサンプリング判断を行うまでSpanを保持します。このため、待機時間を指定するdecision_waitと、保持するTrace数に関わるnum_tracesの設定が重要になります。
decision_waitを短くすると、CollectorがSpanを保持する時間を短縮し、バックエンドへの転送を早められます。一方、長い処理の終了Spanや、ネットワークの遅延によって後から届くSpanが、判断時点でそろわない可能性があります。
反対に待機時間を長くすれば、より多くのSpanが到着するまで待てますが、その間はTraceを保持し続ける必要があります。そのため、メモリ使用量の増加や、保存対象のTraceがバックエンドで検索可能になるまでの遅延につながります。
たとえばdecision_wait: 10sを指定し、毎秒200件の新しいTraceがCollectorへ到着する場合を考えます。単純計算では、10秒間で約2,000件のTraceが新たに到着します。この状況でnum_traces: 1000を設定すると、保持可能なTrace数が不足する可能性があります。
実際の必要容量は、リクエスト数の変動、Spanの到着間隔、TraceごとのSpan数、Collector内部の処理状況などによって変わります。平均的な到着数だけでなく、アクセスが集中したときの増加も考慮する必要があります。
保持容量が不足すると、まだサンプリング判断を行っていないTraceが、内部の保持領域から早期に押し出される場合があります。このとき、本来は保存対象となるはずだったエラーや遅延のTraceも、判断前に失われる可能性があります。
OpenTelemetry Collector Contribの公式READMEでは、このような問題を確認する指標としてotelcol_processor_tail_sampling_sampling_trace_dropped_too_earlyが紹介されています。また、Traceが保持領域から取り除かれるまでの時間を確認するsampling_trace_removal_ageなども、設定の調整に利用できます。利用できる指標名や公開条件はCollectorのバージョンによって確認が必要です。
運用では、実際のSpan到着遅延の分布、長時間処理の所要時間、Collectorのメモリ使用量、サンプリング判断前のドロップ数を確認します。待機時間とメモリ容量は片方だけを調整するのではなく、両方の関係を見ながら設定することが重要です。
また、サンプリング判断後にSpanが到着するケースにも注意が必要です。遅れて到着したSpanについて、過去の保存判断が保持されていない場合、同じTrace IDに対して新しい判断が行われる可能性があります。
Collectorには、過去のサンプリング判断を保持するdecision_cacheという設定も用意されています。保存対象としたTrace IDや、保存しなかったTrace IDの判断を一定数保持することで、遅れて到着したSpanに対して判断の一貫性を保ちやすくなります。ただし、キャッシュには容量の制約があり、判断時点で存在しなかった情報を使って過去の判断をやり直せるわけではありません。
さらに、使用するCollectorの配布版とprocessorの安定性も確認します。公式READMEでは、tail_sampling processorはtraces向けのbetaとして扱われ、Contribなどの配布版に含まれています。Collectorをアップグレードする場合は、設定項目や動作の変更、メトリクスの互換性などを確認し、事前に検証する必要があります。
6. 導入順と検証方法
まず基準値を記録する
サンプリングを導入する前に、現状のトレースデータがどれだけ発生しているかを把握します。開発環境や検証環境で短時間の全件収集を行い、リクエスト数、Trace数、Span数、データ量、エラー数、処理時間の分布を測定します。
この基準値がない状態でサンプリングを有効にすると、データ量が減った理由を正しく判断できません。設定どおりに不要なTraceが除外されたのか、Collectorの処理能力不足によってSpanが失われたのかを区別することが難しくなります。
また、バックエンドの保存期間や料金体系も確認します。データ量に応じて費用が増えるサービスでは、保存するSpan数や容量を減らすことが直接的な費用削減につながる場合があります。一方、料金体系によっては、取り込み量、保持期間、検索回数など、異なる要素が費用に影響します。
次に、サンプリングの目的を明確にします。バックエンドの保存量を減らすことが目的なのか、正常なリクエストを間引いて障害調査に必要なTraceを優先することが目的なのか、Collectorへの負荷を減らすことが目的なのかによって、適切な方式が異なります。
たとえば保存費用の削減が目的であれば、実際にバックエンドへ送られるSpan数やデータ量がどれだけ減少するかを確認します。一方、障害調査の精度を維持することが目的であれば、意図的にエラーを発生させ、そのTraceが保存されるかを確認する必要があります。
ヘッドサンプリングの検証では、十分な件数のリクエストを発生させ、設定した比率と実際の抽出割合を比較します。たとえば10%を設定した状態で10件のリクエストを送信しても、必ず1件が保存されるわけではありません。少数の結果だけを使って設定の正否を判断しないようにします。
テールサンプリングの検証では、正常な短時間処理、ERRORを含む処理、しきい値を超える長時間処理など、条件が異なるリクエストを用意します。それぞれのTraceについて、想定したポリシーが適用されるかを確認します。
特に、エラーを発生させたにもかかわらずTraceが保存されない場合は、まずSpan Statusが想定どおりになっているかを確認します。ポリシーの設定が正しくても、判断材料となる属性やStatusが記録されていなければ、期待した結果になりません。
検証では、保存されたTraceだけでなく、本来保存されるべきだったTraceが欠落していないかを確認することが重要です。サンプリングはデータを減らす仕組みであるため、保存量の減少だけを成功条件にすると、調査精度の低下を見落とす可能性があります。
本番では変更と監視を組にする
本番環境でサンプリングを適用する場合は、設定変更と監視をセットで実施します。適用前後でアプリケーションからの送信量、Collectorの受信量とメモリ使用量、バックエンドの保存量、Traceの検索結果を比較します。
たとえばヘッドサンプリングを有効にした場合、アプリケーションからCollectorへ送信されるSpan数が減ることを確認します。一方、テールサンプリングを導入した場合は、Collectorの受信量を維持しながら、バックエンドへ送る量が減ることを確認します。
このように、どの段階でデータ量が減少したかを確認すると、サンプリングの効果と通信障害による欠落を区別しやすくなります。
エラーを優先保存するテール方式では、意図的にERRORを記録する試験と、長時間処理の試験を用意します。たとえば検証用のAPIでエラーを発生させ、該当するSpan StatusがERRORになっているか、そのTraceがバックエンドに保存されているかを確認します。
遅延を条件にする場合は、しきい値より短い処理と長い処理の両方を実行します。5秒以上のTraceを保存する設定であれば、通常の短時間処理が除外され、5秒を超える処理が保存されるかを確認します。ただし、Spanの到着が遅れる場合、実際の処理時間がしきい値を超えていても判断時点で必要な情報がそろわないことがあります。
複数のCollectorを使用している場合は、同じTraceに属するSpanが同一インスタンスへ届いているかも確認します。単一インスタンスでは正常に動作していても、負荷分散やインスタンスの増減によって保存結果が変わる可能性があるためです。
また、本番環境では通常時のトラフィックだけでなく、障害発生時のデータ量増加も考慮します。たとえば外部サービスの応答が遅くなった場合、同時に処理中のリクエストが増え、Traceの保持時間やCollectorのメモリ使用量が増加する可能性があります。
障害が発生したときにこそ必要なTraceが失われる構成では、サンプリングの目的を十分に達成できません。負荷試験や障害を想定した試験を通じて、通常時と高負荷時の両方で必要な情報が残るかを確認します。
設定変更の履歴には、採用した方式、抽出率、ポリシー、対象サービス、設定変更の理由、元に戻す手順を記録します。問題が発生した場合に、以前の設定へ戻せる状態にしておくことも重要です。
導入後も、トレースの保存量だけでなく、エラーの捕捉状況やCollectorの内部メトリクスを定期的に確認します。アプリケーションの構成変更、アクセス数の増加、サービスの追加などによって、適切なサンプリング設定は変化します。
費用が下がったことだけで完了とせず、障害調査に必要なTraceをどれだけ確保できているかを継続的に評価することが重要です。
まとめ
OpenTelemetryのサンプリングは、トレースの保存量を抑えながら、障害調査に必要な情報を確保するための仕組みです。ヘッドサンプリングは処理開始時点で判断するため、アプリケーションからの転送量を早い段階で削減できます。ParentBasedを利用すれば、分散システムにおいて親のサンプリング判断を引き継ぎ、一つのTraceに属するSpanの記録方針をそろえやすくなります。
一方、テールサンプリングは、Collectorへ到着したSpanのStatusや所要時間を使い、エラーや遅延を優先して保存できます。ただし、判断前のデータを保持する必要があるため、Collectorのメモリ使用量、Spanの到着遅延、Trace単位での集約といった運用上の課題があります。
また、どちらの方式でも、前段で除外されたTraceを後から復元することはできません。監査証跡や重要な業務記録など、欠落を許容できない情報は別の仕組みで確実に保存する必要があります。
サンプリングを導入する際は、保存費用と調査目的を明確にし、現状のデータ量を測定したうえで方式と設定値を選びます。導入後も、正常なデータ削減と異常な欠落を区別し、障害調査に必要なTraceが残ることを継続的に確認しましょう。